Spis treści (22 rozdziały i materiały)
Najważniejsze w skrócie
- SEO powstało, gdy wyszukiwarki zaczęły same czytać strony. Od tej chwili opis dokumentu zaczął decydować o tym, czy ktoś go znajdzie.
- Każda epoka miała swój skrót do wysokich pozycji: powtarzanie fraz, kupowanie linków, masowe teksty. Wyszukiwarki po kolei uczyły się je rozpoznawać.
- PageRank (1998), Panda (2011) i Pingwin (2012) przesunęły uwagę z ilości na pochodzenie linków i jakość treści.
- Telefon i uczenie maszynowe zmieniły sposób oceny stron. Liczy się wersja mobilna, szybkość reakcji strony i zrozumienie całego pytania.
- Od 2023 roku Google testuje odpowiedzi tworzone przez AI, a w maju 2024 roku zaczęło pokazywać AI Overviews w USA. W Polsce Przegląd od AI działa od marca 2025 roku, a Tryb AI od października 2025 roku.
- Z historii wynika jedna praktyczna lekcja: trwałe efekty dają dostępna strona, przydatna treść i reputacja, która ma uzasadnienie poza rankingiem.
Ten przewodnik opisuje, jak zmieniało się pozycjonowanie stron od pierwszych wyszukiwarek z 1990 roku do odpowiedzi AI w 2026 roku. Nie jest katalogiem wszystkich aktualizacji algorytmów. Wybraliśmy wydarzenia, które zmieniły codzienną pracę właścicieli stron, i przy każdym pokazujemy, co z niego wynika dzisiaj.
Daty premier i opisy zmian pochodzą z oficjalnych komunikatów Google, Microsoftu i innych źródeł historycznych, sprawdzonych 27 września 2026 roku. Numery w nawiasach prowadzą do listy źródeł na końcu. Przykłady firm i liczby w przykładach są dydaktyczne: nie przedstawiają wyników naszych klientów ani prognoz.
Rozdział 1Czym jest SEO i po co znać jego historię
Pozycjonowanie stron, czyli SEO (od angielskiego search engine optimization), to praca nad widocznością w bezpłatnych wynikach wyszukiwania. Obejmuje treść, budowę witryny, jej dostępność dla robotów i relacje z innymi stronami. Decyzja o adresie podstrony, nazwie produktu albo usunięciu starego artykułu może zmienić to, czy odbiorca znajdzie odpowiedź.
Historia wyjaśnia, skąd pochodzą dzisiejsze zalecenia. Kto zna epokę prostego dopasowywania słów, szybciej rozpozna tekst pisany pod „gęstość fraz”. Kto rozumie PageRank, wie, dlaczego linki stały się towarem. Wiele dawnych praktyk wciąż pojawia się w ofertach i poradnikach, choć warunki, w których działały, dawno zniknęły.
Cztery pytania przed rankingiem
Zanim strona zajmie jakąkolwiek pozycję, wyszukiwarka musi ją odkryć, pobrać i zdecydować o jej przetworzeniu. Dopiero potem dobiera wyniki do zapytań. Google opisuje ten proces jako skanowanie, indeksowanie i wyświetlanie wyników. Samo opublikowanie strony ani zgłoszenie adresu nie gwarantuje obecności w wynikach.[1]
| Pytanie | Przykład problemu w księgarni internetowej |
|---|---|
| Czy robot znajdzie adres? | Nowa kategoria nie ma linku w menu. |
| Czy pobierze treść? | Lista książek ładuje się dopiero po kliknięciu przycisku. |
| Czy uzna stronę za osobny dokument? | Ta sama lista produktów działa pod kilkunastoma adresami. |
| Czy strona odpowiada na pytanie? | Kategoria jest poprawna technicznie, ale opisuje coś innego, niż szuka klient. |
Każdy z tych problemów wymaga innego działania, chociaż właściciel opisze go tak samo: „nie ma nas w Google”. Ten podział nie jest opisem całego algorytmu. Pomaga odróżnić błąd serwera od słabej odpowiedzi na potrzebę klienta.
SEO a reklama w wyszukiwarce
Wynik organiczny i reklama mogą stać na jednej stronie wyników, ale działają w innych mechanizmach. W reklamie płacisz za udział w emisji według zasad systemu. W SEO inwestujesz w serwis i jego obecność w sieci, bez kupowania konkretnej pozycji. Określenie „bezpłatne wyniki” dotyczy sposobu wyświetlania. Praca autora, programisty czy specjalisty nadal kosztuje.
Źródła i granice pewności
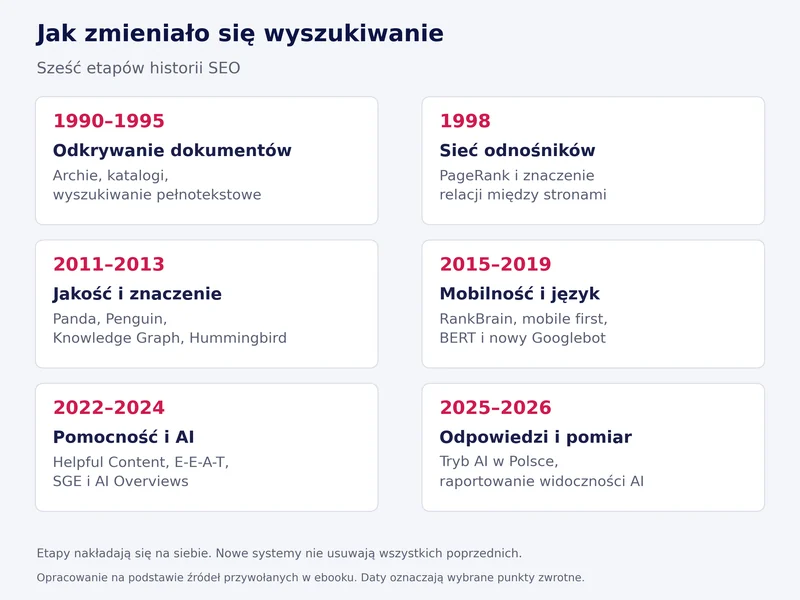
Komunikat wyszukiwarki dobrze dokumentuje, co i kiedy ogłoszono. Nie dowodzi jednak, że każda firma zyskała albo straciła ruch. Opis celu systemu trzeba odróżniać od pomiaru jego skutków. Granice epok w tym przewodniku są umowne: nowe rozwiązania wchodzą stopniowo, a stare mechanizmy często zostają częścią większego systemu.
Rozdział 2Zanim powstało SEO: katalogi i pierwsze wyszukiwarki
Wyszukiwanie w internecie jest starsze niż komercyjne pozycjonowanie. W 1990 roku na Uniwersytecie McGilla rozwijano Archie, narzędzie Alana Emtage’a, Billa Heelana i Petera Deutscha do odnajdywania zasobów w sieci. Działało, zanim WWW stało się codziennym środowiskiem.[2]
W tym samym czasie Tim Berners-Lee tworzył w CERN podstawy World Wide Web. Pod koniec 1990 roku działały pierwszy serwer i przeglądarka. 30 kwietnia 1993 roku CERN udostępnił oprogramowanie WWW w domenie publicznej, co otworzyło drogę do szybkiego rozwoju sieci.[3]
Katalog kontra wyszukiwarka
W małej sieci wystarczy podać komuś adres. W rosnącej potrzebne są pośrednie sposoby odkrywania treści. W 1994 roku Jerry Yang i David Filo stworzyli przewodnik po stronach, z którego wyrosło Yahoo.[4] Użytkownik nie musiał umieć sformułować pytania. Wybierał kategorię, a o obecności strony decydował redaktor katalogu.
Inną drogą poszedł WebCrawler Briana Pinkertona, udostępniony w kwietniu 1994 roku. Automatycznie zbierał dokumenty i przeszukiwał ich treść.[5] AltaVista, uruchomiona publicznie w grudniu 1995 roku w Digital Equipment Corporation, pokazała, jak szybko można przeszukiwać bardzo duży indeks.[6] Dla późniejszego SEO to ważna zmiana: od tej pory liczyło się przede wszystkim to, co program odczyta na stronie.
| Katalog (np. wczesne Yahoo) | Wyszukiwarka pełnotekstowa | |
|---|---|---|
| Kto decyduje o obecności | Redaktor katalogu | Program, który pobiera i czyta strony |
| Jak szuka użytkownik | Wybiera kategorię | Wpisuje własne słowa |
| Co musi zrobić właściciel strony | Przekonać redaktora do właściwej kategorii | Opisać ofertę słowami odbiorców w czytelnym dokumencie |
Dlaczego widoczność zaczęła mieć wartość
Producent części w katalogu branżowym trafiał do jednej kategorii razem z konkurencją. W wyszukiwarce pełnotekstowej każda karta produktu mogła przyprowadzić klienta szukającego konkretnego modelu. Strona główna przestała być jedynymi drzwiami do firmy. Tak powstała zachęta do świadomego pisania dokumentów pod kątem ich odnajdywania.
Nie ma jednej daty „wynalezienia SEO”. Specjalizacja rozwijała się wtedy, gdy widoczność zaczęto systematycznie mierzyć, porównywać i sprzedawać jako usługę.
Rozdział 3Pierwsze techniki pozycjonowania i ich nadużycia
W drugiej połowie lat dziewięćdziesiątych autorzy stron zauważyli, że tytuł, nagłówki, opisy i odnośniki czyta program. Oferta pokazana wyłącznie na obrazku była dla niego niewidoczna. Podstawowa praca polegała więc na jasnym opisaniu oferty zwykłym tekstem.
Szybko pojawiła się pokusa manipulowania prostymi sygnałami. Skoro liczyła się liczba wystąpień frazy, powtarzano ją ponad potrzeby czytelnika. Skoro liczyły się metadane, dopisywano do nich słowa niezwiązane z ofertą. Problem wynikał z tego, że opis dokumentu pisał autor, który miał interes w wysokiej pozycji.
Słowa kluczowe i meta keywords
Słowo kluczowe to sposób nazwania potrzeby. Klient szuka „krzesła do pracy przy biurku”, a producent pisze o „siedzisku operacyjnym”. Dopasowanie języka strony do języka odbiorcy pozostaje przydatne. Nadużycie zaczyna się wtedy, gdy tekst przestaje wyjaśniać ofertę i tylko powtarza zapytania.
We wrześniu 2009 roku Google ogłosiło, że nie używa znacznika meta keywords w rankingu wyszukiwania stron. Jako powód podało wcześniejsze masowe nadużycia tego pola.[7] To dobry przykład na to, jak szybko prosty sygnał traci wartość, gdy każdy może go dowolnie wypełnić.
„Naprawiamy hamulce hydrauliczne i mechaniczne, a przed pracą przedstawiamy wycenę” pomaga klientowi. Dziesięć kolejnych powtórzeń „serwis rowerowy miasto” nie mówi nic o zakresie napraw. Pierwszy tekst zmniejsza niepewność klienta, drugi tylko wydłuża stronę.
Ukrywanie treści i strony przejściowe
W historii SEO pojawiały się też techniki pokazywania robotowi innej treści niż człowiekowi, ukrywania tekstu i tworzenia stron przechwytujących wiele podobnych zapytań. Dzisiejsze zasady Google nazywają je cloakingiem, upychaniem słów kluczowych (keyword stuffing) i stronami przejściowymi (doorway).[8] Wspólny mianownik: strona próbuje zdobyć ocenę za treść, której użytkownik nie dostaje.
Nie każda różnica techniczna jest manipulacją. Strona może zmieniać układ na telefonie, pokazywać walutę kraju albo wymagać logowania do części usług. Przy ocenie pytasz o cel i efekt: czy rozwiązanie pomaga odbiorcy, czy wprowadza wyszukiwarkę w błąd.
Zawód oparty na eksperymencie
Specjalista widział zmiany na stronie i późniejsze wyniki, ale nie znał procesów po stronie wyszukiwarki. To sprzyjało testowaniu i pochopnym wnioskom. Zmiana tytułu mogła zbiec się z sezonowym wzrostem popytu, a dodanie linku z aktualizacją indeksu. Samo następstwo zdarzeń nie dowodzi przyczyny. Ta pułapka wraca w każdej kolejnej epoce SEO, co pokazujemy w rozdziale o ocenie dowodów.
Rozdział 4Google i PageRank: linki jako sygnał reputacji
W 1998 roku Sergey Brin i Lawrence Page opisali wyszukiwarkę Google w pracy „The Anatomy of a Large-Scale Hypertextual Web Search Engine”. System korzystał zarówno z treści stron, jak i ze struktury odnośników między nimi.[9] W tym samym okresie Jon Kleinberg badał huby i autorytety, czyli role, jakie dokumenty pełnią w sieci linków.[10]
Zmiana polegała na wyjściu poza deklarację autora. Strona, która sama mówi o sobie, że jest przydatna, podaje tylko własny opis. Gdy odsyłają do niej inne miejsca w sieci, pojawia się dodatkowa informacja o relacjach. Link nie gwarantuje jakości, ale pomaga ustalić, które dokumenty są ważne w całej strukturze.
Jak rozumieć ideę PageRank
W podstawowej idei PageRank znaczenie strony zależy od linków prowadzących do niej i od znaczenia stron, z których te linki pochodzą. „Głos” strony z wieloma linkami wychodzącymi dzieli się między wszystkie cele. Model można wyjaśnić zachowaniem internauty, który klika w kolejne odnośniki i od czasu do czasu zaczyna od nowa w innym miejscu. To uproszczenie historycznej koncepcji. Dzisiejszy ranking korzysta z wielu innych systemów.[9]
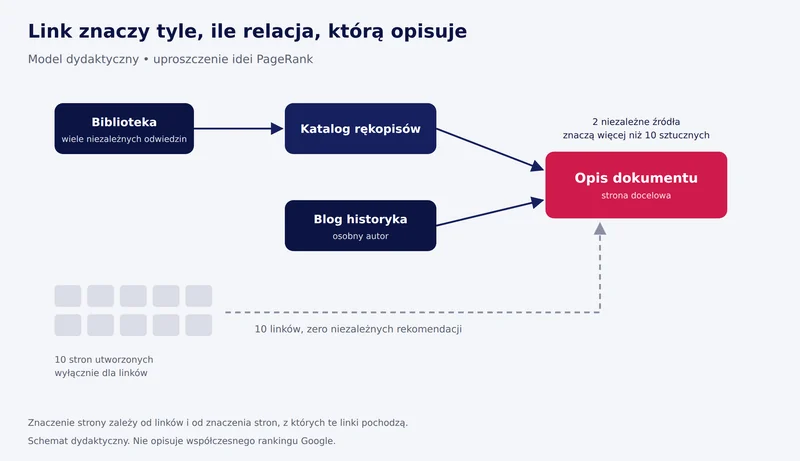
PageRank nigdy nie był całym Google. Już pierwsza praca o wyszukiwarce uwzględniała więcej sygnałów niż sam graf linków.[9] W 2011 roku Google zachęcało właścicieli stron, żeby zamiast wartości PageRank śledzili mierniki prowadzące do konkretnych decyzji.[11]
Dlaczego rynek zaczął handlować linkami
Skoro link jest sygnałem reputacji, zyskuje wartość ekonomiczną. Wydawca może sprzedawać dostęp do swojej publiczności, a ktoś inny może chcieć płacić wyłącznie za wpływ na ranking. Z zewnątrz oba działania wyglądają podobnie, ale mają inny cel. Reklama ma dotrzeć do odbiorcy, manipulacja udaje niezależną rekomendację.
Tak powstał konflikt, który wyjaśnia późniejsze atrybuty linków, działania przeciw spamowi i Pingwina. Lekcja z PageRank nie brzmi „zbierz jak najwięcej linków”. Brzmi: zapytaj, dlaczego ktoś do Ciebie odsyła i co czytelnik dostanie po kliknięciu.
Rozdział 5Komercjalizacja wyszukiwania i zamiar użytkownika
Osoba wpisująca nazwę produktu często jest bliżej zakupu niż ktoś, kto przypadkiem zobaczył baner. Wyszukiwarka stała się miejscem spotkania wyrażonej potrzeby z ofertą. SEO zyskało jasne uzasadnienie biznesowe, ale też presję szybkiego wykazania wyniku.
23 października 2000 roku Google ogłosiło samoobsługowy program reklamowy AdWords. Reklamy były dobierane do słów kluczowych i rozliczane za wyświetlenia.[12] Rozliczanie za kliknięcia, dziś kojarzone z reklamą w wyszukiwarce, nie było więc cechą pierwszej wersji systemu.
Zapytanie mówi o zamiarze
Porównaj trzy zapytania: „jak działa ekspres przelewowy”, „ekspres przelewowy do małego biura” i „filtr do ekspresu model X”. Pierwsza osoba szuka wyjaśnienia, druga porównuje, trzecia potrzebuje konkretnej części. Firma, która kieruje wszystkie trzy zapytania na stronę główną, utrudnia każdemu następny krok. Tu pozycjonowanie spotyka się z architekturą informacji: poradnik, kategoria i karta części mogą współpracować, jeśli prowadzą do siebie czytelnymi linkami.
Od webmastera do zespołu
W małym serwisie jedna osoba pisze, publikuje i poprawia kod. W dużym programista rozwiązuje problem adresów, redaktor pilnuje poprawności, analityk ocenia wynik, a specjalista SEO łączy te perspektywy. Profesjonalizacja SEO to w dużej mierze przejście od pojedynczych trików do współpracy między ludźmi odpowiedzialnymi za różne części doświadczenia klienta.
Sklep rozlicza agencję z liczby fraz w pierwszej dziesiątce. Agencja może wybrać łatwe, rzadko wpisywane hasła. Raport wygląda dobrze, a sklep nie dostaje więcej wartościowych zapytań. Lepszy cel obejmuje konkretne kategorie, potrzeby klientów i wynik sprzedaży. Pozycja zostaje informacją diagnostyczną.
Konkurencja wyszukiwarek
Historia SEO to nie tylko historia Google. 28 maja 2009 roku Microsoft ogłosił Bing jako wyszukiwarkę, która ma pomagać w podejmowaniu decyzji.[13] Marki, partnerstwa i interfejsy się zmieniały, ale konkurencja o trafną odpowiedź trwa. Dla wydawcy płynie z tego wniosek: zależność od jednego źródła ruchu to zależność od cudzych decyzji produktowych. Rozpoznawalna marka i bezpośrednie powroty klientów to rozsądne uzupełnienie SEO.
Rozdział 6Techniczne fundamenty: robots.txt, mapy witryn, canonical i Caffeine
Rosnące serwisy stworzyły problemy, których nie rozwiązywała zmiana tekstu. Sklep generował osobny adres dla każdej kombinacji sortowania, filtra i identyfikatora sesji. Redakcja publikowała kilka wersji tego samego materiału. Wyszukiwarka musiała zdecydować, co pobrać, co uznać za kopię i jak szybko odświeżać zawartość.
| Rok | Rozwiązanie | Jaki problem porządkuje |
|---|---|---|
| 1994 (standard RFC 9309 w 2022) | Robots.txt | Informuje roboty, które zasoby mogą pobierać.[14] |
| 2005 | Mapy witryn XML (Sitemaps) | Podają listę adresów, które wydawca chce udostępnić wyszukiwarce.[15] |
| luty 2009 | rel="canonical" | Wskazuje preferowany adres w grupie podobnych lub powielonych stron.[16] |
| czerwiec 2010 | Caffeine | Nowy system indeksowania, który miał szybciej dostarczać świeże informacje.[17] |
Robots.txt nie chroni danych
Protokół wykluczania robotów zaproponował w 1994 roku Martijn Koster, a jego standaryzację opisuje RFC 9309 z 2022 roku.[14] Plik robots.txt komunikuje zasady pobierania. Nie zabezpiecza poufnych treści. Adres, który naprawdę wymaga ochrony, potrzebuje logowania lub innej kontroli dostępu.
Mapa witryny komunikuje wybór, ale go nie zastępuje
Materiały Google z 2005 roku opisują program Sitemaps i różnicę między mapą XML dla wyszukiwarki a mapą HTML dla odwiedzającego.[15] Sklep z pięcioma tysiącami produktów i dziesiątkami tysięcy adresów z filtrów nie rozwiąże problemu ogromną mapą. Najpierw musi ustalić, czym jest produkt, czym kategoria, a czym chwilowy widok wyników. Dopiero potem świadomie opisze zbiór ważnych adresów.
Canonical porządkuje kopie
W lutym 2009 roku ogłoszono obsługę rel="canonical".[16] Produkt dostępny przez kategorię, kampanię i adres z parametrem to wciąż ten sam dokument, więc wydawca może wskazać adres reprezentatywny. Nie jest to jednak uniwersalna naprawa. Czarne i czerwone krzesło mogą mieć wspólny opis, ale inne zdjęcia i dostępność. Wskazanie wszystkich adresów na stronę główną zniszczyłoby sens rozróżnienia produktów.
Caffeine i świeżość
W czerwcu 2010 roku Google przedstawiło Caffeine, nową infrastrukturę indeksu.[17] Nie wynika z niej reguła „dodaj datę, a pozycja wzrośnie”. Wynik meczu wymaga szybkiej aktualizacji, a instrukcja konserwacji drewnianego stołu może być przydatna przez lata. Odświeżanie samej daty bez zmiany treści niczego nie poprawia.
Techniczne SEO stało się w tym okresie zarządzaniem dokumentami w skali. Jeden dobry szablon poprawia tysiące stron, jeden błąd powiela się równie szeroko. Dlatego udział specjalisty SEO na etapie projektowania serwisu bywa cenniejszy niż późniejsza lista poprawek.
Rozdział 7Panda (2011): koniec planu „więcej stron, więcej ruchu”
Panda stała się symbolem zwrotu ku ocenie jakości treści. W oficjalnych wskazówkach Google pisało o wiarygodności, oryginalności, staranności i użyteczności stron. Zaznaczało też, że w tym samym okresie wprowadzało inne zmiany, więc nie każdy spadek należy przypisywać Pandzie.[18]
Wdrożenie odbywało się etapami
Komunikat z 24 lutego 2011 roku opisywał zmianę uruchomioną w Stanach Zjednoczonych, która według Google zauważalnie dotyczyła 11,8% zapytań. W kwietniu rozszerzono ją na zapytania anglojęzyczne na całym świecie.[19] 12 sierpnia 2011 roku Google ogłosiło wejście Pandy do kolejnych języków, z wyjątkiem chińskiego, japońskiego i koreańskiego. Dla większości z nich podało zasięg 6–9% zapytań.[20]
11,8% to deklarowany odsetek zapytań, w których zmiana była zauważalna. Nie jest to odsetek ukaranych witryn ani średni spadek ruchu. Skrót „Panda zabrała stronom 12% ruchu” brzmi wiarygodnie, ale zmienia sens komunikatu. Przy każdej aktualizacji sprawdzaj trzy rzeczy: datę, rynek i definicję miary.
Ilość przestała wystarczać
Fikcyjny portal o wyposażeniu mieszkań ma osobne artykuły „jak wybrać biurko”, „wybór biurka do pokoju”, „jakie biurko wybrać” i „dobre biurko do mieszkania”. Każdy zaczyna się podobnym wstępem i zdaniem o ergonomii. Właściciel widzi cztery szanse na ruch. Czytelnik widzi cztery wersje niedokończonego poradnika.
Rozsądna redakcja zaczyna od zadania odbiorcy: wymiarów, ustawienia monitora, porównania materiałów i przykładów aranżacji. Dopiero wtedy wiadomo, czy wystarczy jeden rozbudowany materiał, czy potrzebne są osobne poradniki dla różnych sytuacji. Liczba adresów wynika wtedy z projektu treści.
Audyt treści jako praca redakcyjna
Każdemu artykułowi można przypisać jedną z czterech decyzji: zachować, poprawić, połączyć albo wycofać. Nie jest to automat oparty na liczbie wejść. Tekst bez ruchu może odpowiadać na rzadkie, ale ważne pytanie klientów. Popularny tekst może zawierać nieaktualną poradę. Masowe kasowanie stron tylko dlatego, że mało kto je czyta, potrafi zniszczyć przydatny zasób.
Zmieniła się też rola autora. Zlecenie „napisz dwa tysiące znaków o regulacji fotela” można zastąpić opisem zadania: wyjaśnij kolejność ustawienia wysokości, podparcia i odległości od biurka oraz wskaż ograniczenia konstrukcji. Druga wersja nie narzuca sztucznej długości, za to wymaga konkretów.
Rozdział 8Pingwin (2012) i nowe myślenie o linkach
24 kwietnia 2012 roku Google ogłosiło zmianę wymierzoną w webspam, później nazwaną Penguin (Pingwin). Komunikat pokazywał upychanie fraz i schematy linkowania. Jednocześnie Google uznało „white hat” SEO za działanie, które pomaga użytkownikom i wyszukiwarkom.[21] Ułatwienie odczytu strony, język klientów i dobra nawigacja to co innego niż wytwarzanie pozorów niezależnej rekomendacji.
Profil linków opowiada historię
Link to ślad relacji: recenzji, dokumentacji, artykułu prasowego, dyskusji albo reklamy. Fikcyjny sklep ogrodniczy może zdobyć link z poradnika o podlewaniu, bo przygotował przydatną tabelę doboru węży. Może też kupić pakiet tysięcy linków z przypadkowych stron. W obu raportach liczba linków rośnie, ale tylko pierwszy scenariusz ma powód, dla którego człowiek kliknie.
Nie wynika z tego, że każdy link musi pochodzić ze strony o identycznej tematyce. Lokalna gazeta może sensownie opisać dowolną firmę z miasta. Liczą się kontekst i funkcja publikacji. Mechaniczne podobieństwo kategorii ma mniejsze znaczenie.
Disavow, Pingwin w głównym algorytmie i atrybuty linków
W październiku 2012 roku Google udostępniło narzędzie disavow do wskazywania linków, których właściciel nie chce uwzględniać w ocenie swojej witryny. Już wtedy Google przedstawiało je jako narzędzie do konkretnych problemów z nienaturalnymi linkami, do używania z rozwagą.[22] 23 września 2016 roku Pingwin stał się częścią głównego algorytmu. Google opisało przetwarzanie na bieżąco, w miarę ponownego pobierania stron, oraz neutralizowanie spamu zamiast obniżania oceny całej witryny.[23]
Atrybut nofollow wprowadzono w 2005 roku. We wrześniu 2019 roku Google dodało wartości sponsored i ugc, które opisują linki sponsorowane i tworzone przez użytkowników. Wszystkie trzy oznaczenia stały się wskazówkami, a dla skanowania i indeksowania zmiana dotycząca nofollow zaczęła obowiązywać od 1 marca 2020 roku.[24]
Zanim zapłacisz za publikację z linkiem, zapytaj: czy miałaby sens, gdyby nie dawała żadnej korzyści w rankingu? Czy trafia do odbiorców, buduje rozpoznawalność albo kieruje zainteresowanych do oferty? Jeśli sprzedawca umie podać tylko liczbę linków, nie wyjaśnia wartości relacji.
Rozdział 9Od słów do znaczeń: Knowledge Graph, Hummingbird i schema.org
Użytkownik często zna problem, ale nie zna nazwy rozwiązania. Wpisuje „urządzenie do mierzenia wilgoci w ścianie”, a sprzedawca używa fachowej nazwy produktu. Wyszukiwarka oparta na dosłownej zgodności słów ma kłopot z połączeniem tych opisów. Wyszukiwanie semantyczne to próba uchwycenia relacji między językiem, pojęciami i rzeczywistymi obiektami.
16 maja 2012 roku Google przedstawiło Knowledge Graph, który rozpoznaje osoby, miejsca i rzeczy oraz związki między nimi.[25] Oficjalny przewodnik po systemach Google opisuje Hummingbirda jako istotne ulepszenie całego systemu rankingowego, wprowadzone w sierpniu 2013 roku.[26] To dwa różne mechanizmy.
Encja i kontekst
Encja to rozpoznawalny obiekt lub pojęcie: konkretna osoba, firma, miejscowość albo dzieło. Słowo „Jaguar” może oznaczać zwierzę albo markę samochodów. Zapytanie o spalanie i zapytanie o środowisko życia podpowiadają, o który sens chodzi. Dla autora strony wynika z tego prosta zasada: pisz jednoznacznie. Tekst o firmie mówi, czym się zajmuje i gdzie działa. Opis produktu pozwala odróżnić model od całej serii.
Intencja jako zadanie do wykonania
Zapytania dzieli się zwykle na informacyjne, nawigacyjne, komercyjne i transakcyjne. To przydatna klasyfikacja robocza, ale prawdziwe potrzeby nie zawsze mieszczą się w jednej szufladzie. „Najlepszy aparat na wyjazd” może oznaczać pierwszy etap nauki albo zakup przed jutrzejszą podróżą. Zamiast przyklejać etykietę, opisz warunki decyzji: co odbiorca już ma, jakie ograniczenie rozwiązuje i czy potrzebuje porównania, instrukcji czy informacji o dostępności.
Dane uporządkowane jako wspólny język
2 czerwca 2011 roku Google, Bing i Yahoo ogłosiły wspólny słownik schema.org.[27] Dane uporządkowane pozwalają wskazać, które elementy strony opisują produkt, przepis czy organizację. Mogą pomagać w interpretacji strony i umożliwiać bogatszą prezentację wyników, ale muszą opisywać treść widoczną dla użytkownika.[28] Jeśli sklep pokazuje brak towaru, a dane sugerują pełną dostępność, problemem jest niespójność. Poprawny technicznie zapis nie czyni opisu prawdziwym.
Rozdział 10Wyniki uniwersalne i wyszukiwanie lokalne
Wczesna wyszukiwarka pokazywała listę dziesięciu linków. Z czasem pojawiły się obrazy, wiadomości, mapy, filmy i bezpośrednie informacje. Google wskazuje rok 2007 jako moment wprowadzenia Universal Search, które połączyło różne rodzaje wyników na jednej stronie.[29]
To zmieniło znaczenie pozycji. Pierwszy tradycyjny link mógł być nisko na ekranie, jeśli nad nim stały mapa, zdjęcia i reklamy. Dwa zapytania z tą samą średnią pozycją mogły dawać zupełnie inne szanse na kliknięcie. Sam ranking przestał opisywać to, co użytkownik naprawdę widzi.
Format jest częścią odpowiedzi
Osoba szukająca „jak złożyć namiot” skorzysta z filmu albo ilustrowanej instrukcji. Ktoś, kto wpisuje „wymiary namiotu model X”, potrzebuje tabeli parametrów. Pytanie o sklep turystyczny w pobliżu wymaga adresu i godzin otwarcia. Jeden długi tekst nie jest najlepszą odpowiedzią na wszystkie trzy potrzeby.
Lokalizacja zmienia odpowiedź
Google wyjaśnia, że o wynikach lokalnych decydują trafność, odległość i rozpoznawalność firmy. Pełne dane o działalności pomagają ustalić dopasowanie, a położenie użytkownika wpływa na zbiór sensownych wyników.[30] Nie istnieje więc jedna pozycja lokalnej firmy dla całego miasta. Piekarnia jest świetnym wynikiem dla kogoś dwa skrzyżowania dalej i słabszym dla osoby po drugiej stronie aglomeracji.
Rozwój interfejsu przygotował też grunt pod odpowiedzi bez kliknięcia. Klient, który w wynikach lokalnych znalazł godziny otwarcia i przyszedł do sklepu, nie zostawił sesji na stronie, a mimo to efekt nastąpił. Dla wydawcy utrzymującego się z odwiedzin ta sama funkcja może oznaczać stratę. Oceniaj ją z perspektywy własnego modelu biznesowego.
Rozdział 11Telefon zmienia zasady projektowania stron
Smartfon postawił wydawcom konkretne wymagania: mały ekran, obsługa palcem i różne warunki połączenia. Strona wygodna na monitorze bywała bezużyteczna w ruchu. Część uwagi SEO przesunęła się w stronę sposobu korzystania z witryny.
| Data | Zmiana | Co oznaczała |
|---|---|---|
| sierpień 2014 | HTTPS jako sygnał rankingowy | Google określiło jego wagę jako niewielką.[31] |
| 21 kwietnia 2015 | Aktualizacja mobile-friendly | Promowanie stron przyjaznych telefonom w wynikach mobilnych, ocenianych strona po stronie.[32] |
| listopad 2016 | Pierwsze eksperymenty mobile-first indexing | Indeksowanie na podstawie wersji mobilnej.[33] |
| 2021 | Page experience | Stopniowe wdrożenie oceny doświadczenia strony, a w module najważniejszych wiadomości koniec wymogu AMP.[34] |
| październik 2023 | Koniec przejścia na mobile-first | Google ogłosiło zakończenie wieloletniej zmiany.[35] |
| marzec 2024 | INP zastępuje FID | Nowa miara responsywności w Core Web Vitals.[36] |
Popularna nazwa „Mobilegeddon” oddawała emocje branży w 2015 roku, ale nie opisywała skutków dla każdej witryny. Komunikat podkreślał, że mobilna przyjazność nie unieważnia innych sygnałów, w tym dopasowania do zapytania.[32]
Mobilna użyteczność a mobilne indeksowanie
To dwa różne pojęcia. Mobilna użyteczność dotyczy tego, czy człowiek wygodnie korzysta ze strony na telefonie. Mobile-first indexing oznacza, że do indeksowania Google używa mobilnej wersji treści. Fikcyjny sklep, który na komputerze ma pełny opis produktu, a na telefonie tylko nazwę, cenę i zdjęcie, upraszcza ekran kosztem informacji potrzebnych do decyzji. Problemem nie jest responsywny układ, tylko uboższa treść.
Core Web Vitals opisują odczuwalne problemy
Core Web Vitals mierzą ładowanie, responsywność i stabilność wizualną. W marcu 2024 roku INP zastąpił FID jako miarę responsywności.[36] Przycisk „dodaj do koszyka” może pojawić się szybko, a potem reagować z opóźnieniem. Baner może przesunąć formularz w chwili wpisywania danych. Jedna liczba „szybkości” nie opisuje wszystkich tych problemów. Pamiętaj też, że technologia promowana w danej epoce, jak AMP, nie jest wiecznym warunkiem sukcesu.
Rozdział 12Uczenie maszynowe: RankBrain, BERT i MUM
AI nie pojawiła się w wyszukiwarce dopiero razem z generowanymi odpowiedziami. Google wiąże RankBrain z 2015 rokiem i opisuje go jako system, który pomaga łączyć słowa z pojęciami.[37] W 2019 roku Google ogłosiło użycie modelu BERT, który lepiej rozumie kontekst słów w zdaniu, zwłaszcza w dłuższych zapytaniach.[38] W 2021 roku zaprezentowało MUM, model rozumiejący informacje w wielu językach i formatach.[39]
„Czy laptop można ładować przez monitor” i „czy monitor można zasilać z laptopa” mają wspólne rzeczowniki, ale kierunek zależności zmienia odpowiedź. Dobry poradnik nazywa złącze, opisuje wymagania sprzętu i odróżnia zasilanie od przesyłania obrazu. Nie potrzebuje specjalnego stylu „pisania pod BERT”.
Jak czytać zapowiedzi technologiczne
Późniejsza dokumentacja Google zaznacza, że MUM nie jest używany do ogólnego rankingu, tylko do wybranych zastosowań.[26] Z tej historii wynika metoda: oddzielaj możliwości badawcze modelu, konkretną wdrożoną funkcję i jej rzeczywisty zasięg. Pokaz na konferencji nie dowodzi, że system od jutra odpowiada za każdy wynik w każdym języku.
Narzędzia dla autorów zaczęły w tym czasie podpowiadać tematy i terminy do uwzględnienia. Mogą służyć jako lista pytań do sprawdzenia, ale nie zastępują wiedzy. Wynik podobieństwa do tekstów konkurencji nie mówi, czy Twoja publikacja zawiera prawdziwą odpowiedź albo nowe ustalenie.
Rozdział 13E-E-A-T, pomocna treść i AI w pisaniu
W grudniu 2022 roku Google dodało doświadczenie do pojęć opisanych skrótem E-A-T. Powstało E-E-A-T: doświadczenie, wiedza specjalistyczna, autorytet i wiarygodność (experience, expertise, authoritativeness, trustworthiness). Zmiana dotyczyła wytycznych dla osób oceniających jakość wyników.[40]
E-E-A-T to rama oceny jakości, a nie publiczna punktacja przyznawana domenie. Zewnętrzni oceniający pomagają Google sprawdzać działanie systemów. Ich ocena nie ustawia ręcznie pozycji konkretnej strony.[41]
Doświadczenie i wiedza to różne dowody
Osoba, która przez miesiąc dojeżdżała z plecakiem do pracy, wiarygodnie opisze wygodę kieszeni i zachowanie materiału w deszczu. Konstruktor wyjaśni właściwości tkaniny. Obie perspektywy są cenne, ale dotyczą innej wiedzy. Zdanie „plecak jest wytrzymały” mówi niewiele. Opis czasu użytkowania, obciążenia i widocznego zużycia pozwala czytelnikowi ocenić, czy warunki przypominają jego sytuację.
Helpful Content i marzec 2024
W sierpniu 2022 roku Google zapowiedziało aktualizację helpful content, skupioną na treściach tworzonych przede wszystkim dla ludzi.[42] W marcu 2024 roku opisało włączenie oceny pomocności do głównych systemów rankingowych i odejście od osobnego systemu. W tym samym komunikacie ogłosiło zasady przeciw nadużywaniu wygasłych domen, masowemu tworzeniu treści w celu manipulacji i wykorzystywaniu reputacji cudzej witryny.[43]
Nazwa aktualizacji żyje w branży długo po tym, jak system zmienił formę. Diagnoza „uderzył Helpful Content” bez daty, danych i sprawdzenia innych przyczyn jest zbyt ogólna, żeby prowadzić do planu naprawy.
AI nie zwalnia z redakcji
W lutym 2023 roku Google wyjaśniło, że ocenia jakość i cel treści niezależnie od tego, jak powstała. Problemem pozostaje automatyzacja używana głównie do manipulowania wynikami.[44] Automatyczny opis produktu przygotowany z dobrze uporządkowanej specyfikacji może oszczędzić pracę. Automatyczne dopisanie nieistniejących cech produktu to błąd, który uderzy w klienta. Jeśli tempo publikacji przekracza możliwości sprawdzania, rośnie ryzyko pomyłek.
Rozdział 14Polski kontekst rozwoju SEO
Polskie pozycjonowanie rozwijało się w warunkach własnego języka, rosnącej liczby serwisów i upowszechniania handlu w sieci. Historia Wirtualnej Polski zaczyna się w 1995 roku.[45] Dla wielu użytkowników portale i katalogi były punktem startu, zanim wpisywanie pytań w wyszukiwarkę stało się odruchem.
Odmiana a mechaniczne dopasowanie fraz
Polszczyzna ma bogatą odmianę, a ludzie opisują te same potrzeby różnymi konstrukcjami. „Naprawa rowerów”, „naprawić rower” i „gdzie oddać rower do naprawy” nie wymagają trzech niemal identycznych stron. Kłopot pojawia się, gdy umowa lub narzędzie traktuje dosłowną frazę jako jedyną jednostkę wartości i autor musi wstawić każde hasło w mianowniku. Powstają wtedy nienaturalne zdania. Winny jest proces pracy. Język polski nie wymaga „pisania dla robota”.
Wymiana linków w polskich wynikach
W kwietniu 2007 roku blog Google dla webmasterów opublikował po polsku wpis „Linkowanie”, poświęcony wymianie i kupowaniu linków na polskich stronach oraz ocenie odnośników.[46] To ślad, że problem sztucznych linków był omawiany w Polsce na długo przed Pingwinem. W branżowym języku funkcjonowały określenia takie jak zaplecze, katalogowanie czy systemy wymiany linków. Ocenę warto opierać na tym, jak dane rozwiązanie działa: dodatkowy serwis może być pełnoprawną publikacją dla odbiorców albo zbiorem stron istniejących tylko po to, by przekazywać sygnały.
Lokalne wdrożenia mają własne daty
Globalna premiera nie oznacza jednoczesnej dostępności w Polsce. Google ogłosiło udostępnienie Przeglądu od AI w Polsce 26 marca 2025 roku, a Trybu AI 8 października 2025 roku.[47][48] Pisząc o historii dla polskiego czytelnika, trzeba odróżniać te daty od wcześniejszych premier w Stanach Zjednoczonych. Ta sama ostrożność przydaje się przy raportach: badanie zachowań odbiorców w jednym kraju nie musi opisywać polskiego rynku.
Rozdział 15Jak zmieniało się mierzenie efektów
Najprostszy raport SEO mówi, na którym miejscu strona pojawia się dla wybranej frazy. Dojrzalszy pyta, kto ją zobaczył, czy wszedł na stronę i co zrobił dalej. Historia pomiaru to stopniowe przejście od pojedynczej pozycji do oceny całej drogi klienta. Różne dane służą różnym decyzjom, więc nie chodzi o wymianę jednego miernika na drugi.
18 października 2011 roku Google ogłosiło szyfrowanie wyszukiwania dla zalogowanych użytkowników. Odwiedzana strona przestała dostawać od nich informację o wpisanym zapytaniu.[49] To ważny etap historii „not provided” w analityce. Nie oznacza to, że od tego dnia wszystkie dane o zapytaniach zniknęły ze wszystkich narzędzi.
Search Console i spojrzenie od strony wyszukiwarki
20 maja 2015 roku Google zmieniło nazwę Webmaster Tools na Search Console.[50] Nowa nazwa lepiej oddawała krąg odbiorców: dane o widoczności przydają się też redaktorom, analitykom i właścicielom firm. Raport wyszukiwarki i analityka strony opisują różne etapy. Pierwszy dotyczy wyświetleń i kliknięć w wynikach, druga zachowania po wejściu. Rozbieżność liczb nie musi być błędem, bo systemy mają inne definicje i ograniczenia.
Strona ma 10 000 wyświetleń i 400 kliknięć, więc CTR wynosi 4%. Później ma 20 000 wyświetleń i 600 kliknięć. CTR spada do 3%, a liczba wejść rośnie o połowę. Zdanie „skuteczność spadła” byłoby niepełne. Jeśli jednak w tym czasie zapytania ofertowe spadły z 20 do 18, większy ruch nie przełożył się na kontakty i trzeba szukać przyczyny: trafności odbiorców, oferty albo formularza. Liczby są wymyślone i nie są benchmarkiem.
Porównania muszą zachować kontekst
Sezonowość, zmiana asortymentu i kampania marki zmieniają ruch niezależnie od SEO. Sklep z artykułami szkolnymi nie porówna sierpnia z listopadem tak jak dwóch podobnych sezonów. Nowa popularna kategoria może podnieść łączny ruch i jednocześnie ukryć problem starych produktów. Dlatego dziel dane według rodzaju stron, urządzeń, krajów i typów zapytań, a raport zaczynaj od czterech pytań: co się zmieniło, gdzie to widać, jaki ma skutek biznesowy i jakie są możliwe wyjaśnienia.
Rozdział 16Nowa fala technicznego SEO: JavaScript, IndexNow i migracje
W aplikacjach internetowych treść coraz częściej powstaje dopiero po wykonaniu kodu w przeglądarce. Serwer zwraca szkielet dokumentu, a JavaScript dociąga opis produktu, cenę i linki. Google opisuje przetwarzanie takich stron w trzech krokach: skanowanie, renderowanie i indeksowanie.[51] Błędne jest zarówno twierdzenie, że Google w ogóle nie czyta JavaScriptu, jak i założenie, że każda aplikacja zostanie odczytana bez problemów.
7 maja 2019 roku Google ogłosiło, że Googlebot korzysta z aktualnego wówczas silnika Chromium 74 i będzie go regularnie aktualizował.[52] Możliwość uruchomienia kodu nie gwarantuje jednak kompletnej treści. Jeśli aplikacja pobiera ważne dane z niedostępnego źródła albo pokazuje je dopiero po szczególnej interakcji, nowy silnik tego nie naprawi.
- Odpowiedź serwera. Co dostaje robot, zanim wykona się jakikolwiek skrypt?
- Strona po renderowaniu. Czy po wykonaniu kodu widać opis, cenę i linki do ważnych podstron?
- Widok użytkownika. Czy człowiek dostaje tę samą treść, a komunikat „nie znaleziono produktu” idzie w parze z właściwym kodem odpowiedzi?
IndexNow: powiadamianie o zmianach
18 października 2021 roku Bing ogłosił IndexNow, protokół opracowany wspólnie z Yandex. Pozwala powiadamiać uczestniczące wyszukiwarki o dodaniu, zmianie lub usunięciu adresu.[53] To inny element procesu niż ocena trafności: informacja „dokument się zmienił” nie mówi, czy zasługuje on na wysoką pozycję. Obsługa protokołu przez jedną wyszukiwarkę nie oznacza obsługi przez wszystkie, więc przed wdrożeniem sprawdź aktualną listę uczestników.
Mapy witryn, Caffeine, renderowanie i IndexNow rozwiązują różne problemy: odkrywanie adresów, aktualność indeksu, odczytanie treści i komunikowanie zmian. Wrzucanie ich do jednego worka „szybszego pozycjonowania” zaciera te różnice.
Migracja jako sprawdzian dojrzałości
Zmiana platformy, domeny albo struktury adresów pokazuje, czy firma rozumie swój zasób. Plan obejmuje listę ważnych stron, przypisanie im odpowiedników i sprawdzenie, czy treść zachowuje funkcję. Jeśli wszystkie stare adresy trafią na stronę główną, klient szukający konkretnego produktu straci kontekst. Bez dziennika zmian późniejszy spadek ruchu łatwo przypisać aktualizacji Google, choć przyczyna leży w serwisie.
Crawler potrafi wykryć tysiące ostrzeżeń, ale ich liczba nie jest planem. Powielony tytuł na kilku stronach pomocniczych waży mniej niż niedostępna główna kategoria. Kolejność oceny zaczyna się od pytania, czy odbiorca i robot dostają właściwy dokument. Dopiero potem sens mają drobniejsze poprawki.
Rozdział 17Wyszukiwanie w erze generatywnej AI
Generatywna AI zmieniła interfejs wyszukiwania. Obok odnajdywania dokumentów pojawiły się odpowiedzi, które łączą informacje z wielu źródeł.
| Data | Wydarzenie |
|---|---|
| 10 maja 2023 | Google prezentuje eksperymentalne Search Generative Experience.[54] |
| 14 maja 2024 | Google zaczyna udostępniać AI Overviews wszystkim użytkownikom w Stanach Zjednoczonych.[55] |
| 5 marca 2025 | Google ogłasza eksperymentalny AI Mode.[56] |
| 26 marca 2025 | Przegląd od AI w Polsce, po polsku i po angielsku.[47] |
| 8 października 2025 | Tryb AI w Polsce.[48] |
| 10 lutego 2026 | Bing udostępnia testowy raport AI Performance w Bing Webmaster Tools.[57] |
| 3 czerwca i 31 sierpnia 2026 | Google ogłasza raporty widoczności w funkcjach generatywnych w Search Console, a potem udostępnia je wszystkim witrynom.[58] |
Podstawy SEO nadal obowiązują
Dokumentacja Google o AI Overviews i AI Mode nie wymaga osobnej optymalizacji ani nowego rodzaju pliku dla tych funkcji. Strona, do której prowadzi link w odpowiedzi, musi być zaindeksowana i kwalifikować się do wyświetlenia fragmentu w wynikach. Google zaznacza też, że te funkcje mogą wykonywać wiele powiązanych wyszukiwań, żeby przygotować odpowiedź.[59]
To podważa obietnice typu „jeden znacznik zapewni obecność w odpowiedziach AI”. Nie znaczy jednak, że forma informacji jest obojętna. Jednoznaczne nazwy, opis metody pomiaru i oddzielenie faktów od opinii to cechy dobrego źródła. W branży używa się nazw GEO i AEO na pracę nad widocznością w odpowiedziach generatywnych, ale ich zakres nie jest jednolity. W rozmowie z wykonawcą ustal, czy chodzi o technikę, treść, reputację, pomiar cytowań czy wszystko naraz.
Cytowanie i ruch to różne wielkości
Raport Bing AI Performance pokazuje, jak często treści witryny są cytowane w Microsoft Copilot, podsumowaniach AI w Bing i wybranych integracjach partnerów.[57] Raporty Google w Search Console pokazują wyświetlenia w AI Overviews, AI Mode i funkcjach generatywnych w Discover, z podziałem m.in. na strony i kraje. Od 31 sierpnia 2026 roku są dostępne dla wszystkich witryn.[58]
Cytowanie nie jest automatycznie wizytą, rekomendacją ani sprzedażą. Liczba wzmianek bez oceny kontekstu działa jak dawna liczba fraz w TOP 10: wygląda efektownie, ale mówi niewiele o wyniku firmy. Pojedynczy test pytania w czacie też nie jest pomiarem rynku. Własny monitoring powinien zapisywać datę, język, narzędzie i treść pytania.
Otwarte pytania dla wydawców
Kierunek zmian jest czytelny: wyszukiwarka przejmuje część pracy porównywania i streszczania informacji. Skutki dla sklepu, specjalistycznego wydawcy i firmy usługowej mogą być różne. Rozsądnie jest wzmacniać zasoby wymagające bezpośredniego kontaktu, na przykład konfigurator, własną bazę danych albo usługę, i budować rozpoznawalność źródła. Historia nie daje podstaw do ogłaszania końca SEO. Pokazuje, że przedmiot pracy rozszerza się razem ze sposobem, w jaki ludzie szukają informacji.
Rozdział 18Aktualizacje algorytmów i mity branżowe
Aktualizacja wyszukiwarki to zdarzenie w systemie, a spadek ruchu to obserwacja dotycząca Twojego serwisu. Związek między nimi trzeba zbadać. Oficjalny przewodnik Google po spadkach ruchu wymienia m.in. problemy techniczne, zmiany algorytmiczne, sezonowość i zmianę zainteresowania tematem.[60]
| Mit | Jak jest naprawdę |
|---|---|
| Każdy spadek to kara od Google | Ręczne działanie za naruszenie zasad, zmiana automatycznej oceny i utrata ruchu po awarii to trzy różne sytuacje, każda wymaga innego działania. |
| Istnieje idealna długość tekstu i gęstość frazy | Instrukcja resetu urządzenia potrzebuje kilku kroków, porównanie technologii szerszego omówienia. Łatwa mierzalność nie dowodzi znaczenia miernika. |
| Każde powtórzone zdanie to kara za duplikację | Google opisuje kanonizację jako wybór reprezentatywnego adresu spośród kopii.[61] Porządkujesz serwis, gdy kilka stron konkuruje o tę samą funkcję. |
| Da się zagwarantować pierwsze miejsce | Wynik zależy od zapytania, kontekstu, konkurencji i systemów poza kontrolą wykonawcy. Wykonawca może zobowiązać się do zakresu pracy, jakości wdrożeń i raportowania. |
Ruch sklepu spada dzień po wdrożeniu nowej platformy, a branża akurat dyskutuje o aktualizacji Google. Łatwo połączyć oba fakty. Jeśli jednak główne kategorie zniknęły z menu, a opisy z kart produktów, to zmiana serwisu daje konkretną hipotezę do sprawdzenia. Aktualizacja pozostaje tłem, które nie zastępuje diagnozy.
Jak analizować zmianę krok po kroku
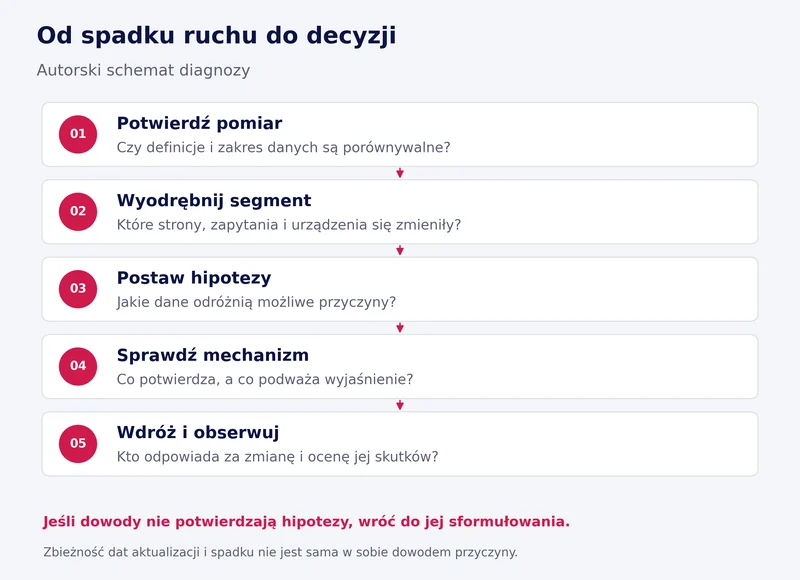
- Potwierdź pomiar. Sprawdź, czy dane są porównywalne i czy nie zmieniła się konfiguracja narzędzi.
- Określ zasięg. Cała witryna czy grupa stron, wszystkie urządzenia czy wybrane, zapytania z nazwą marki czy ogólne.
- Zestaw zmiany. Porównaj wdrożenia w serwisie, informacje o wyszukiwarce i zmiany popytu.
- Sformułuj hipotezy, które da się odróżnić. Błąd formularza sprawdzasz testem formularza, zmianę popytu porównaniem sezonów.
- Wdrażaj i obserwuj. Zapisz datę, zakres zmiany i termin ponownej oceny.
Rozdział 19Jedna firma w kolejnych epokach
Poniższa historia jest w całości przykładem dydaktycznym. Fikcyjny sklep i warsztat rowerowy „Koło” pozostaje podobny, a zmienia się otoczenie technologiczne i oczekiwania klientów.
Kilka stron: opis sklepu, adres, lista usług. Liczy się jasny tytuł i tekstowy opis. Ryzyko: zastąpienie informacji listą fraz z nazwą miasta przy każdej usłudze, zamiast odpowiedzi, czy warsztat przyjmuje rowery innych marek.
Karty produktów, kategorie, polecenia lokalnych klubów rowerowych. Pojawia się oferta pakietu tanich linków. Właściciel pyta o pochodzenie, odbiorców i trwałość i nie dostaje odpowiedzi poza liczbą linków.
Kilkadziesiąt podobnych tekstów o doborze opon zastępuje jeden spójny przewodnik z podziałem na rowery miejskie i terenowe. Pracownicy obsługi zaczynają używać go w odpowiedziach klientom.
Godziny, dojazd i dostępność usługi są aktualne, formularz uproszczony, a opisy kompletne także na małym ekranie. Miernikiem stają się rezerwacje i sensowne zapytania.
Firma publikuje porównania oparte na własnych obserwacjach warsztatowych, z opisem metody i datą aktualizacji. Śledzi ruch i cytowania w odpowiedziach AI, ale nie zakłada, że każde cytowanie to zakup.
Narzędzia i formaty się zmieniają, ale firma wciąż potrzebuje tych samych odpowiedzi: komu pomaga, co wie, gdzie udostępnia informacje i jak rozpoznaje efekt. Największe błędy pojawiają się wtedy, gdy miara zastępuje cel.
Rozdział 20Jak oceniać dowody w SEO
Prawdziwa obserwacja może prowadzić do błędnego wyjaśnienia. Ruch wzrósł po zmianie tytułów, ale w tym samym czasie zaczął się sezon. Serwis stracił widoczność w czasie aktualizacji, ale dzień wcześniej z menu zniknęły ważne linki. Rzetelna analiza pozwala innej osobie odtworzyć tok rozumowania. Poniżej opisujemy autorską metodę porządkowania pracy.
Cztery rodzaje twierdzeń
| Rodzaj | Przykład | Czego wymaga |
|---|---|---|
| Fakt źródłowy | 7 maja 2019 roku Google ogłosiło aktualizowany silnik Googlebota.[52] | Wiarygodnego źródła z datą |
| Obserwacja | Po wdrożeniu nowych opisów kliknięcia wzrosły o 18%. | Poprawnego pomiaru |
| Interpretacja | Nowe opisy spowodowały wzrost o 18%. | Wykluczenia innych przyczyn |
| Rekomendacja | Przepiszmy wszystkie opisy. | Uzasadnienia, że efekt przeniesie się na inne strony |
Oficjalny komunikat wiarygodnie dokumentuje datę i deklarowany cel systemu, ale nie mierzy efektu dla Twojego sklepu. Studium przypadku pokazuje wynik jednego serwisu, ale nie uprawnia do twierdzeń o wszystkich branżach. Rodzaj źródła dobieraj do rodzaju pytania.
Porównanie „przed i po” nie wystarcza
Fikcyjny eksperyment: dwa podobne zbiory kategorii mają po 1000 kliknięć. W pierwszym zmieniasz prezentację informacji, drugi zostaje bez zmian. Po okresie obserwacji pierwszy ma 1450 kliknięć, a drugi 1200. Prosty raport przypisze wdrożeniu wzrost o 45%. Tymczasem grupa porównawcza też urosła o 20%.
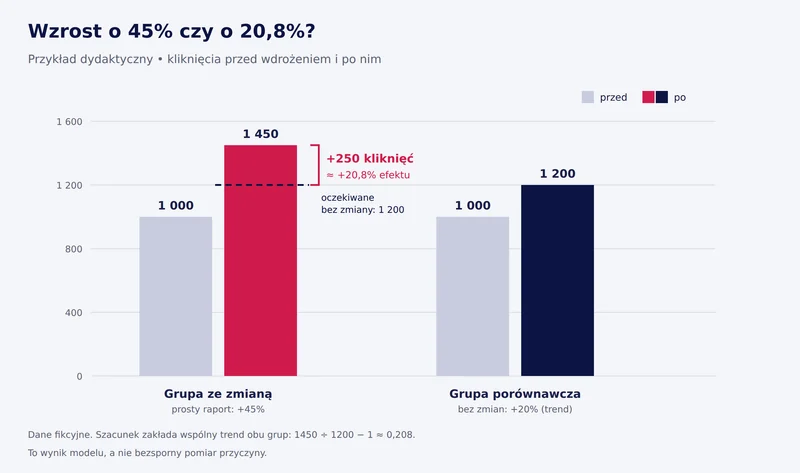
Przy założeniu podobnego trendu pierwsza grupa bez wdrożenia miałaby 1200 kliknięć. Różnica 250 kliknięć to około 20,8% względem tego poziomu (1450 ÷ 1200 − 1 = 0,2083). To wynik modelu opartego na założeniu wspólnej dynamiki, więc przyczynę trzeba potwierdzić innymi danymi. Grupy mogły różnić się sezonowością, liczbą produktów albo konkurencją, więc porównaj też ich trendy sprzed wdrożenia.
Nie każdy projekt pozwala na dobry eksperyment. Awarii nie naprawiasz później tylko po to, żeby zachować grupę kontrolną. Wtedy uczciwie opisujesz analizę jako obserwacyjną i sprawdzasz, czy naprawiony mechanizm działa.
Rejestr dowodów zamiast kolekcji pewników
Dobry rejestr zawiera datę obserwacji, zakres adresów, źródło danych, opis wdrożenia, wynik i ograniczenia. Dołączasz eksport albo zrzut raportu, bo interfejs narzędzia się zmieni. Każdy wniosek dostaje termin ponownej oceny, szczególnie gdy dotyczy szybko zmieniających się funkcji AI.
Rozdział 21Jak czytać raport bez mylenia widoczności ze sprzedażą
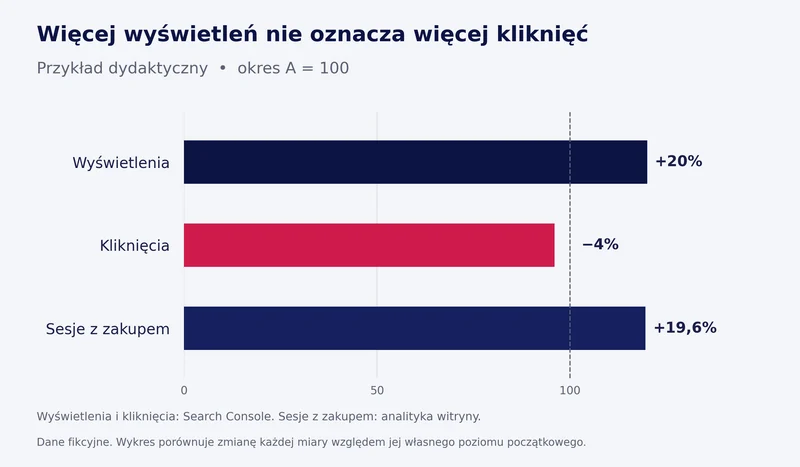
Poniższy przykład jest w całości dydaktyczny. Liczby nie pochodzą od klienta, nie są benchmarkiem ani prognozą. Pokazują, jak różne miary jednego projektu mogą zmieniać się w przeciwnych kierunkach. Mamy dwa okresy po 28 dni, A i B, z tą samą konfiguracją pomiaru. Dla przejrzystości każda sesja z zakupem to jedno zamówienie.
| Miara | Okres A | Okres B |
|---|---|---|
| Wyświetlenia w Search Console | 100 000 | 120 000 |
| Kliknięcia w Search Console | 5 000 | 4 800 |
| CTR w Search Console | 5,0% | 4,0% |
| Sesje Google organic w analityce | 4 600 | 4 400 |
| Sesje zakończone zakupem | 92 | 110 |
| Udział sesji z zakupem | 2,0% | 2,5% |
CTR to kliknięcia podzielone przez wyświetlenia.[62] Spadek z 5% do 4% to jeden punkt procentowy, czyli 20% wartości początkowej. Tych dwóch opisów nie wolno zamieniać. Udział sesji z zakupem liczymy w innym systemie: 92 ÷ 4600 = 2% i 110 ÷ 4400 = 2,5%. Nie dzielimy zamówień z jednego raportu przez kliknięcia z drugiego, bo kliknięcia i sesje mają różne definicje.
Co z tych danych naprawdę wynika
Wyświetlenia wzrosły o 20%, kliknięcia spadły o 4%, a sesje z zakupem wzrosły o około 19,6%. Nie można powiedzieć, że projekt się pogorszył, bo stracił część kliknięć. Nie można też ogłosić sukcesu SEO bez zbadania innych czynników: poprawy oferty, dostępności produktów albo zmiany przypisania konwersji. Tabela pozwala zadać pytania, ale ich nie rozstrzyga. Następny raport powinien rozdzielić poradniki, kategorie i produkty.
Pułapka średniej pozycji
Strona ma 10 000 wyświetleń na pozycji 2 i 1000 wyświetleń na pozycji 20. Średnia ważona wyświetleniami wynosi około 3,64. W kolejnym okresie druga grupa rośnie do 10 000 wyświetleń, a pozycje się nie zmieniają. Średnia rośnie do 11.
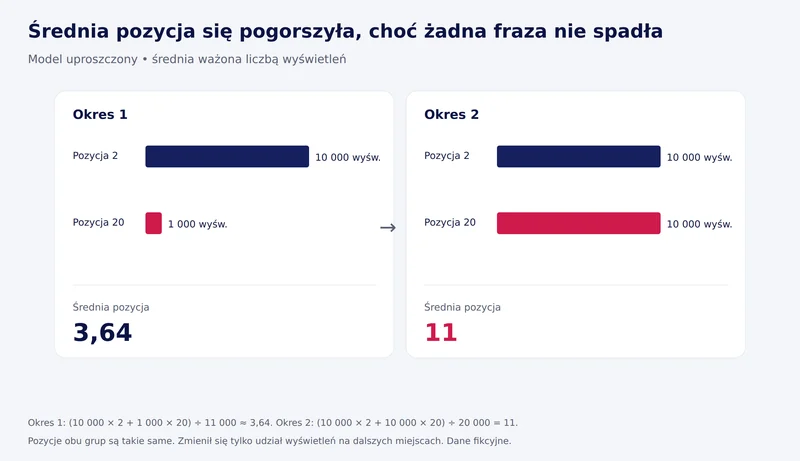
Wzrost widoczności na dalszych miejscach pogorszył średnią całego zbioru. Dlatego w raporcie zestawiaj też stały zbiór zapytań i stron. Podobnie działa średni CTR: jeśli rośnie udział zapytań ogólnych, łączny CTR spada mimo poprawy w poszczególnych grupach.
Wniosek dla osoby zarządzającej
„W badanym okresie kliknięcia zmalały o 4%, a sesje z zakupem wzrosły o 19,6%. Wzrost wyświetleń przy spadku CTR wymaga analizy udziału poszczególnych typów zapytań. W kolejnym kroku sprawdzimy osobno poradniki i strony sprzedażowe oraz potwierdzimy, że pomiar działa tak samo”.
Taki zapis zawiera wynik, granicę wiedzy i następne działanie. Nie ukrywa niekorzystnej miary, ale nie daje jej monopolu na interpretację. Obecność w odpowiedziach AI opisuj osobno: pojawienie się marki, przywołanie konkretnego adresu, poprawność kontekstu i wejście na stronę to cztery różne zdarzenia.
Rozdział 22Historia SEO jako standard pracy
Z epoki prostych fraz wynika potrzeba zrozumiałego języka. Z historii linków wynika znaczenie pochodzenia rekomendacji. Z Pandy wynika odpowiedzialność za treść. Z mobile-first wynika kontrola wersji, którą wyszukiwarka faktycznie czyta. Z rozwoju AI wynika konieczność oddzielenia obecności źródła od ruchu.
Karta rekomendacji
Zamiast „należy poprawić linkowanie” zapisz: „nowe kategorie nie mają linków z żadnej widocznej części nawigacji”, dołącz przykładowe adresy i sposób sprawdzenia. Opisz mechanizm: link kontekstowy ułatwi dotarcie do kategorii. Efekt techniczny sprawdzisz od razu: link działa, prowadzi pod właściwy adres i jest widoczny także na telefonie. Ocena wpływu na sprzedaż może przyjść później.
| Element karty | Pytanie |
|---|---|
| Obserwacja | Jaki problem widać i na których adresach? |
| Mechanizm | Dlaczego zmiana ma pomóc? |
| Zakres i właściciel | Kto wdraża, kto zatwierdza treść i kod? |
| Odbiór | Jak sprawdzimy, że zmiana działa? |
| Ocena efektu | Jakie dane i kiedy obejrzymy? |
| Powrót | Jak cofniemy zmianę, jeśli wprowadzi błąd? |
Priorytet wynika z problemu
Pierwszeństwo mają przeszkody, które blokują dostęp do ważnej treści albo wykonanie podstawowego zadania. Niedostępne kategorie wymagają innej reakcji niż niespójna wielkość liter w kilku tytułach. Łatwa zmiana oparta na słabej hipotezie nie zawsze zasługuje na pierwszeństwo. Unikaj też wdrażania wszystkiego naraz: jeśli w jednym tygodniu zmienisz domenę, szablon, treść i kategorie, nie ocenisz skutków żadnej z tych zmian.
Cztery zasady na dziś
- Oddzielaj zasób od chwilowej przewagi. Przydatna dokumentacja, dobra architektura i rzetelna baza wiedzy pomagają w wyszukiwaniu, obsłudze klienta i sprzedaży. Sztuczne sygnały mają wartość tylko tak długo, jak długo zewnętrzny system je nagradza.
- Zaczynaj od diagnozy. Przy każdym zaleceniu zapisz problem, przewidywany mechanizm poprawy i dowód, po którym poznasz zmianę.
- Prowadź dziennik zmian. Cel, zakres, osoba odpowiedzialna i termin obserwacji wystarczą, żeby za rok nie zgadywać, co się wydarzyło w serwisie.
- Czytaj źródła z datą i kontekstem. Wpis historyczny dokumentuje wydarzenie ze swojego okresu, a aktualne wymagania sprawdzasz w bieżącej dokumentacji.
Wyszukiwarki będą dalej zmieniać sposób odkrywania informacji. Firma, która jasno opisuje swoją wiedzę, udostępnia ją w przydatnej formie i sprawdza efekty, ma lepszą podstawę do zmian niż ta, która szuka kolejnego sekretnego parametru.
KalendariumNajważniejsze daty w historii SEO
Daty dotyczą wybranych premier, komunikatów i wdrożeń. Nie oznaczają, że wszystkie wyszukiwarki i rynki zmieniły się tego samego dnia. Szerszy opis znajdziesz w rozdziałach.
- Archie na Uniwersytecie McGilla
Odnajdywanie zasobów w sieci przed upowszechnieniem WWW.[2]
- WWW w CERN
Pierwszy serwer i przeglądarka, a 30 kwietnia 1993 roku oprogramowanie WWW w domenie publicznej.[3]
- AltaVista
Szybkie przeszukiwanie dużego indeksu.[6]
- Praca Brina i Page’a o Google
Treść i struktura linków w opisie wyszukiwarki.[9]
- AdWords
Samoobsługowa reklama przy zapytaniach.[12]
- Caffeine
Przebudowa infrastruktury indeksowania.[17]
- Hummingbird
Ulepszenie całego systemu rankingowego.[26]
SłownikSłownik pojęć
- AEO i GEO
- Nazwy pracy nad obecnością w odpowiedziach bezpośrednich i generatywnych. Zakres trzeba ustalić w każdym projekcie.
- AI Overviews (Przegląd od AI)
- Podsumowania tworzone przez AI nad wynikami wyszukiwania Google.
- AI Mode (Tryb AI)
- Tryb wyszukiwania Google do rozbudowanych pytań i dalszej rozmowy.
- Anchor text
- Widoczny tekst linku. Powinien mówić, dokąd link prowadzi.
- Backlink
- Link z innej strony do Twojej. Sama liczba nie mówi nic o pochodzeniu i kontekście.
- Canonical
- Adres reprezentatywny dla grupy kopii lub bardzo podobnych stron.
- Cloaking
- Pokazywanie robotowi innej treści niż człowiekowi w celu manipulacji.
- Core update
- Szeroka aktualizacja głównych systemów rankingowych Google.
- Core Web Vitals
- Wskaźniki ładowania (LCP), responsywności (INP) i stabilności układu (CLS).
- CTR
- Stosunek kliknięć do wyświetleń w wynikach.
- Disavow
- Narzędzie do wskazania linków, których Google ma nie uwzględniać. Nie jest uniwersalną naprawą spadków.
- E-E-A-T
- Doświadczenie, wiedza, autorytet i wiarygodność. Rama oceny jakości. Nie ma publicznej punktacji domeny.
- Encja
- Rozpoznawalny obiekt lub pojęcie, na przykład firma, osoba albo miasto.
- Indeksowanie
- Przetwarzanie i zapisywanie informacji o stronie na potrzeby wyszukiwania.
- Intencja
- Zadanie albo potrzeba, z którą ktoś wpisuje zapytanie.
- Mobile-first indexing
- Indeksowanie na podstawie mobilnej wersji treści.
- Nofollow, sponsored, ugc
- Atrybuty opisujące charakter linku: bez rekomendacji, sponsorowany, od użytkowników.
- Noindex
- Instrukcja wykluczenia strony z indeksu. Robot musi móc ją odczytać.
- PageRank
- Historyczna metoda oceny znaczenia stron na podstawie linków. Nie jest całym rankingiem Google.
- Renderowanie
- Wykonanie kodu strony i zbudowanie jej widoku, ważne przy aplikacjach JavaScript.
- Robots.txt
- Plik z zasadami pobierania dla robotów. Nie zabezpiecza danych.
- SERP
- Strona wyników wyszukiwania.
- Zero click
- Wyszukiwanie zakończone bez kliknięcia w zewnętrzną stronę.
PytaniaNajczęstsze pytania o historię pozycjonowania
Kiedy powstało pozycjonowanie stron?
Nie ma jednej daty. Pozycjonowanie rozwinęło się w połowie lat dziewięćdziesiątych, gdy wyszukiwarki pełnotekstowe, takie jak WebCrawler (1994) i AltaVista (1995), zaczęły same odczytywać treść stron. Wtedy opis dokumentu zaczął wpływać na to, czy ktoś go znajdzie. Zawodem SEO stało się, gdy widoczność zaczęto mierzyć i sprzedawać jako usługę.
Czym był PageRank i czy nadal ma znaczenie?
PageRank to opisana w 1998 roku metoda oceny znaczenia stron na podstawie linków: ważna jest strona, do której odsyłają inne ważne strony. Nigdy nie był całym rankingiem Google. Linki nadal są sygnałem reputacji, ale liczy się ich pochodzenie i kontekst, a nie sama liczba.
Co zmieniły aktualizacje Panda i Pingwin?
Panda z 2011 roku skupiła uwagę na jakości treści i uderzyła w model publikowania wielu podobnych, płytkich stron. Pingwin z 2012 roku był wymierzony w webspam, w tym schematy linkowania. W 2016 roku Pingwin stał się częścią głównego algorytmu i działa na bieżąco.
Czy meta keywords wpływa na pozycje w Google?
Nie. We wrześniu 2009 roku Google ogłosiło, że nie używa znacznika meta keywords w rankingu wyszukiwania stron, bo był masowo nadużywany. Inne metadane, jak tytuł strony i meta description, mają nadal znaczenie dla prezentacji wyniku.
Od kiedy Google indeksuje wersję mobilną stron?
Google ogłosiło pierwsze eksperymenty z mobile-first indexing w listopadzie 2016 roku, a zakończenie przejścia w październiku 2023 roku. Oznacza to, że do indeksowania używana jest mobilna wersja treści, więc na telefonie nie mogą brakować informacji ważnych dla klienta.
Kiedy Przegląd od AI i Tryb AI pojawiły się w Polsce?
Google ogłosiło udostępnienie Przeglądu od AI (AI Overviews) w Polsce 26 marca 2025 roku, a Trybu AI (AI Mode) 8 października 2025 roku. Wcześniejsze daty z 2023 i 2024 roku dotyczą testów i premier w Stanach Zjednoczonych.
Czy Google karze treści pisane z pomocą AI?
Według wyjaśnienia Google z lutego 2023 roku liczą się jakość i cel treści, a nie sam sposób jej powstania. Problemem jest automatyzacja używana głównie do manipulowania wynikami. Tekst przygotowany z pomocą AI wymaga takiej samej redakcji i sprawdzenia faktów jak każdy inny.
Czy SEO ma sens w czasach odpowiedzi AI?
Tak. Dokumentacja Google wskazuje, że do AI Overviews i AI Mode nie jest potrzebna osobna optymalizacja: strona musi być zaindeksowana i kwalifikować się do wyświetlenia fragmentu w wynikach. Zmienia się pomiar, bo cytowanie w odpowiedzi AI nie jest tym samym co wizyta na stronie, dlatego te zjawiska warto śledzić osobno.
Czytaj dalejPowiązane materiały
Zespół icomSEOAutorzy przewodnika
Przewodnik przygotowało pięć osób z zespołu icomSEO. Karty poniżej prowadzą do profili autorów.
 Piotr AntoszekPrezes spółkiProfil autora →
 Katarzyna TobołaSpecjalistka marketingu internetowego i sprzedaży B2BProfil autora →
 Jacek KałużaChief Operating OfficerProfil autora →
 Arkadiusz UrbaśChief Technology OfficerProfil autora →Daria GrudzieńCopywriterka SEO i specjalistka content marketinguProfil autora →
Materiały źródłoweŹródła
Oficjalne komunikaty, dokumentacja i materiały historyczne sprawdzone 27 września 2026 roku. Wpisy historyczne opisują stan z dnia publikacji, a aktualne wymagania sprawdzaj w bieżącej dokumentacji.
- Jak działa wyszukiwarka Google, Google Search Central
- Towards the McGill of Tomorrow (Archie), Uniwersytet McGilla
- Krótka historia WWW, CERN
- Our story, Yahoo
- Internet history and Internet Tools Summary, ibiblio
- The AltaVista Search Revolution (1996), Richard Seltzer i współautorzy
- Google nie używa meta keywords w rankingu (wrzesień 2009), Google Search Central
- Zasady dotyczące spamu w wyszukiwarce Google, Google Search Central
- The Anatomy of a Large-Scale Hypertextual Web Search Engine (1998), Sergey Brin, Lawrence Page
- Authoritative Sources in a Hyperlinked Environment, Jon Kleinberg
- Beyond PageRank: Graduating to actionable metrics (czerwiec 2011), Google Search Central
- Google Launches Self-Service Advertising Program (23 października 2000), Google
- Microsoft’s New Search at Bing.com (28 maja 2009), Microsoft
- RFC 9309: Robots Exclusion Protocol (wrzesień 2022), RFC Editor
- Google Sitemap a mapa HTML (26 września 2005), Google Search Central
- Specify your canonical (12 lutego 2009), Google Search Central
- Our new search index: Caffeine (czerwiec 2010), Google Search Central
- Wskazówki dotyczące stron wysokiej jakości (maj 2011), Google Search Central
- Finding more high-quality sites in search (24 lutego i 11 kwietnia 2011), Google
- High-quality sites algorithm launched in additional languages (12 sierpnia 2011), Google Search Central
- Another step to reward high-quality sites (24 kwietnia 2012), Google Search Central
- A new tool to disavow links (październik 2012), Google Search Central
- Penguin is now part of our core algorithm (23 września 2016), Google Search Central
- Ewolucja nofollow: sponsored i ugc (10 września 2019), Google Search Central
- Introducing the Knowledge Graph (16 maja 2012), Google
- Przewodnik po systemach rankingowych Google, Google Search Central
- Introducing schema.org (2 czerwca 2011), Google Search Central
- Wprowadzenie do danych uporządkowanych, Google Search Central
- 25 biggest moments in Search (2023), Google
- Widoczność w lokalnych wynikach Google, Pomoc Profilu Firmy
- HTTPS as a ranking signal (sierpień 2014), Google Search Central
- Rolling out the mobile-friendly update (21 kwietnia 2015), Google Search Central
- Mobile-first indexing (4 listopada 2016), Google Search Central
- Page experience update: więcej czasu i szczegółów (kwiecień 2021), Google Search Central
- Mobile-first indexing has landed (31 października 2023), Google Search Central
- Introducing INP to Core Web Vitals (2023, aktualizacja 2024), Google Search Central
- How AI powers great search results (2022), Google
- Understanding searches better than ever before: BERT (październik 2019), Google
- MUM: A new AI milestone for understanding information (maj 2021), Google
- Aktualizacja wytycznych dla oceniających: E-E-A-T (15 grudnia 2022), Google Search Central
- Przydatne i wiarygodne treści tworzone dla ludzi, Google Search Central
- Helpful content update (sierpień 2022), Google Search Central
- March 2024 core update and new spam policies (5 marca 2024), Google Search Central
- Wyszukiwarka Google a treści tworzone przez AI (luty 2023), Google Search Central
- Historia Wirtualnej Polski, Wirtualna Polska Holding
- Linkowanie (kwiecień 2007), Google Search Central
- Funkcja Przegląd od AI teraz dostępna w większej liczbie krajów Europy (26 marca 2025), Google Polska
- Wyszukiwarka Google: wprowadzamy Tryb AI w Polsce (8 października 2025), Google Polska
- Making search more secure (18 października 2011), Google
- Announcing Google Search Console (20 maja 2015), Google Search Central
- Podstawy SEO dla JavaScriptu, Google Search Central
- The new evergreen Googlebot (7 maja 2019), Google Search Central
- IndexNow: Instantly Index your web content (18 października 2021), Microsoft Bing
- Supercharging Search with generative AI (10 maja 2023), Google
- Generative AI in Search: Let Google do the searching for you (14 maja 2024), Google
- Expanding AI Overviews and introducing AI Mode (5 marca 2025), Google
- Introducing AI Performance in Bing Webmaster Tools (10 lutego 2026), Bing Webmaster Blog
- Raporty skuteczności funkcji generatywnych w Search Console (3 czerwca i 31 sierpnia 2026), Google Search Central
- Funkcje AI a Twoja witryna, Google Search Central
- Diagnoza spadków ruchu z wyszukiwarki, Google Search Central
- Czym jest kanonizacja, Google Search Central
- Wyświetlenia, pozycja i kliknięcia, Pomoc Search Console




