Spis treści (31 rozdziałów i dodatki)
Najważniejsze ustalenia
Audyt bezpieczeństwa sprawdza, czy zabezpieczenia strony działają w procesach firmy: przy logowaniu, zamówieniu, płatności, pracy integracji i odtwarzaniu kopii. Dla WordPressa i WooCommerce oznacza to ocenę całej instalacji, uprawnień, danych i sposobu wprowadzania zmian.
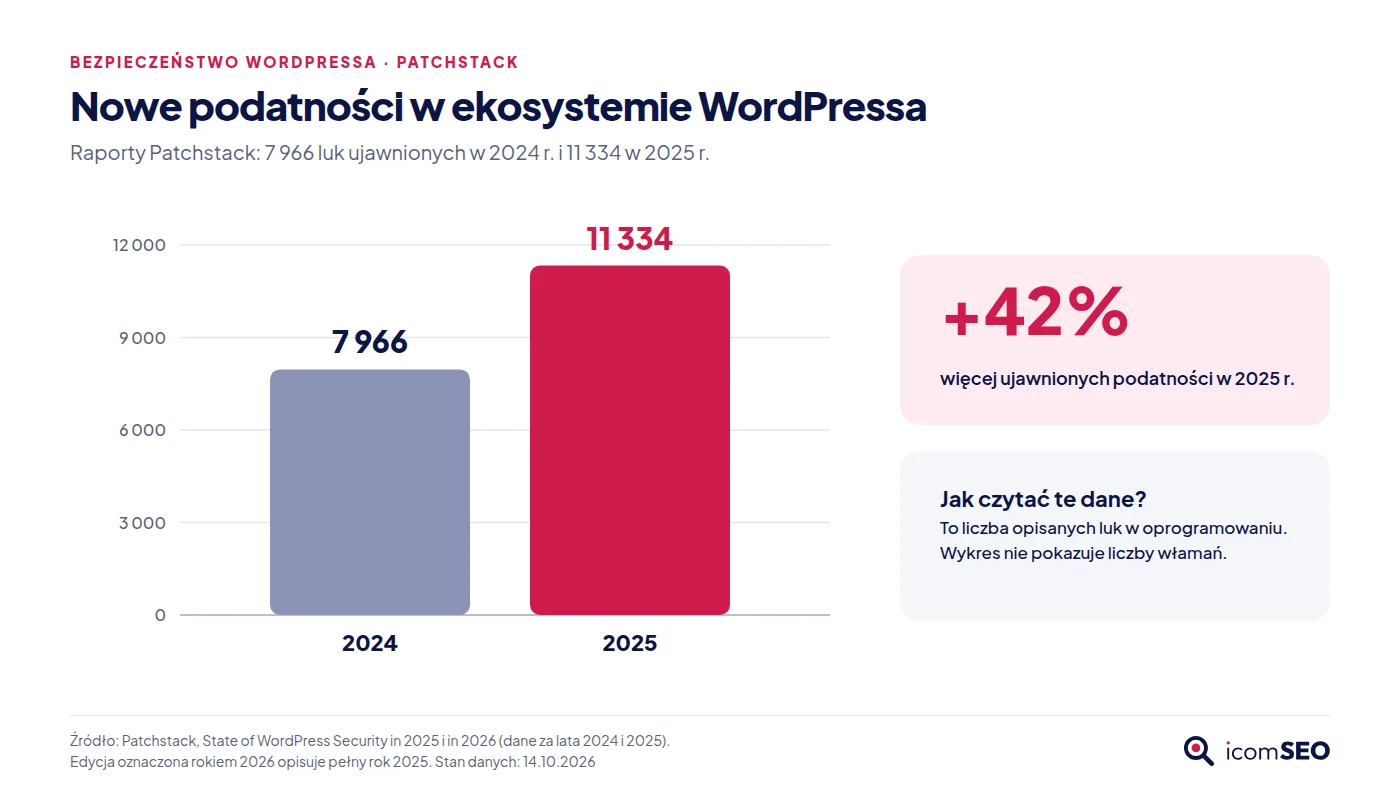
- Patchstack opisał 7 966 nowych podatności w ekosystemie WordPressa w 2024 r. i 11 334 w 2025 r., czyli o około 42% więcej.[3][4]
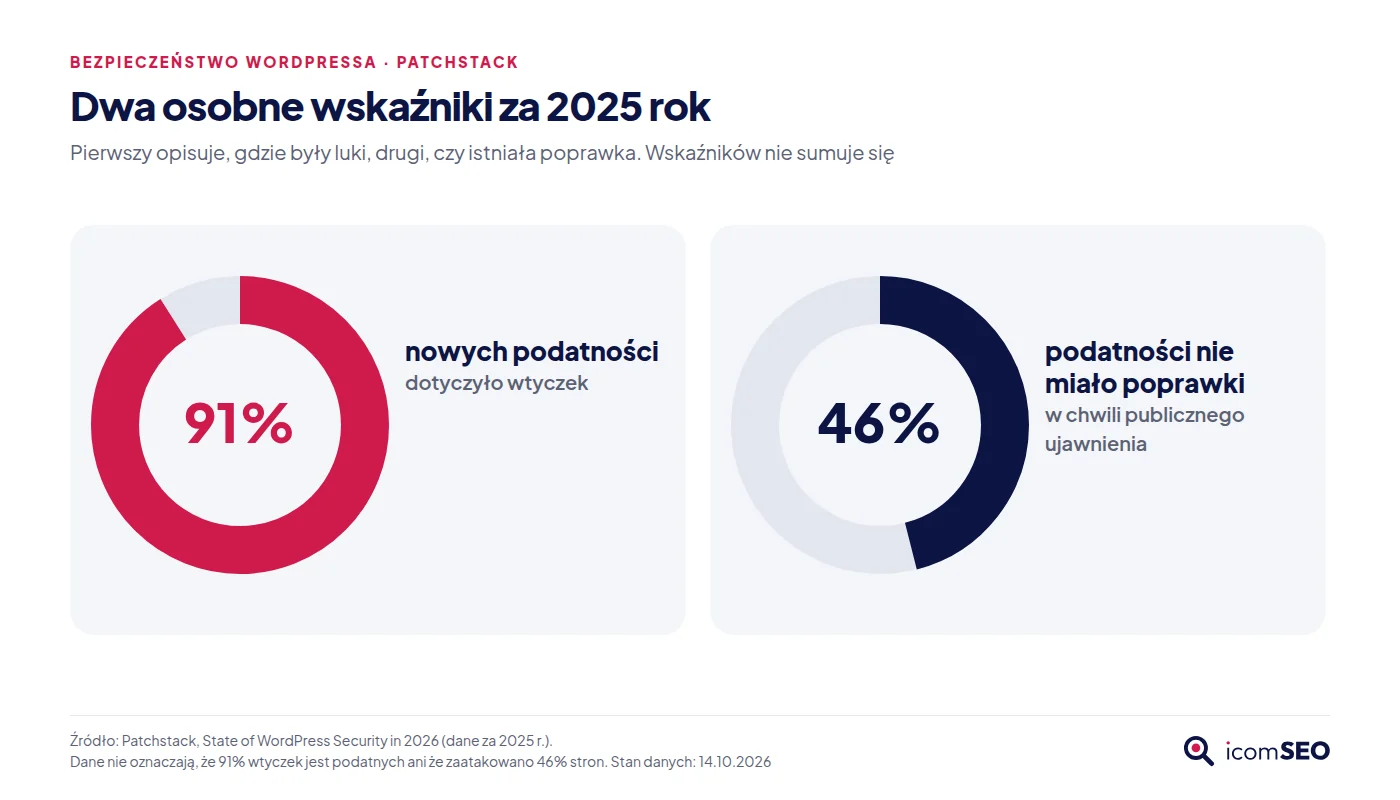
- W 2025 r. 91% nowych podatności dotyczyło wtyczek, a 46% nie miało poprawki producenta w chwili publicznego ujawnienia.[4]
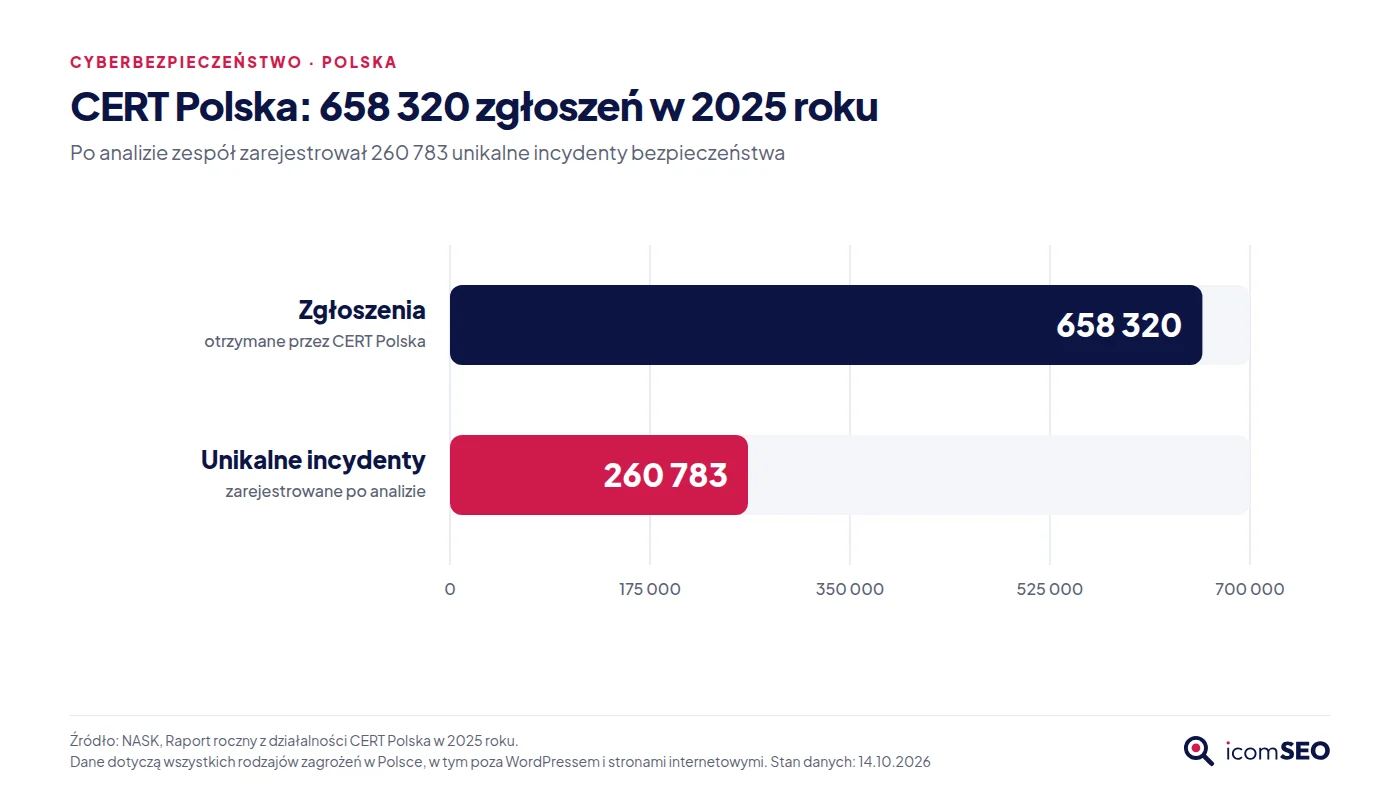
- CERT Polska otrzymał w 2025 r. 658 320 zgłoszeń i zarejestrował 260 783 unikalne incydenty bezpieczeństwa, we wszystkich obszarach zagrożeń.[5]
- Naruszenie ochrony danych zgłasza się UODO bez zbędnej zwłoki, w miarę możliwości w ciągu 72 godzin od jego stwierdzenia.[43]
- Nowelizacja ustawy o KSC obowiązuje od 3 kwietnia 2026 r. O obowiązkach decyduje status podmiotu. Samo korzystanie z WordPressa lub prowadzenie sklepu o nim nie przesądza.[46][47]
- Przewodnik zawiera 31 rozdziałów, trzy scenariusze testów (SCN-01–03), kartę 12 kryteriów odbioru, plan 30–60–90 dni i pięć wzorów do pracy.
Stan opracowania: 14 października 2026 r. Numery w nawiasach prowadzą do listy 100 źródeł. Oddzielamy informacje ze źródeł, praktykę proponowaną przez icomSEO i przykłady hipotetyczne. Scenariusze i modele kosztów nie opisują badania konkretnej witryny.
Strona może mieć ważny certyfikat, aktualny system i zainstalowaną wtyczkę ochronną, a mimo to ujawniać dane klientów albo pozwalać na nieuprawnione operacje. Profesjonalny audyt bezpieczeństwa sprawdza, czy zabezpieczenia działają w rzeczywistych procesach firmy: od logowania i składania zamówienia po odtworzenie serwisu po incydencie. Lista podatności znaleziona przez narzędzie jest tylko jednym z jego elementów.[1][8][12][39]
Dla właściciela firmy dobry wynik audytu brzmi tak: wiemy, które scenariusze mogą zaszkodzić firmie, co potwierdziły testy, kto odpowiada za naprawę i jak sprawdzimy jej skuteczność. Do takiego wyniku potrzebna jest analiza techniczna, znajomość procesów i raport, z którym da się pracować.[6][57]
Przewodnik jest przeznaczony dla właścicieli stron, e-commerce managerów, agencji i zespołów technicznych. Łączy wymagania wobec aplikacji z praktyką utrzymania WordPressa i WooCommerce. Scenariusze, wzory odbioru i przykłady liczbowe są modelowe: nie opisują audytu konkretnej witryny i nie są standardami wymaganymi przez prawo. Część prawna ma charakter informacyjny, a zastosowanie przepisów zależy od oceny konkretnej organizacji.
Jak czytać ten przewodnik
Właściciel firmy może zacząć od rozdziału 1, rozdziałów 17 i 18 oraz 25, 28 i 30. Opisują cel audytu, decyzje o ryzyku, model kosztów, mierniki i jakość usługi. Zespół techniczny znajdzie zakres prac w rozdziałach 8–14, a scenariusze, zasady zmian i pochodzenie kodu w rozdziałach 20–23. Przepisy omawia rozdział 15. Dodatki A–E zawierają wzory odbioru i dokumentowania pracy.
W całym tekście oddzielamy trzy rodzaje informacji: to, co wynika ze źródła, praktykę proponowaną przez icomSEO i przykład hipotetyczny. Wymaganie prawne, zalecenie techniczne i warunek współpracy to osobne kategorie.
Sześć decyzji właściciela przed rozpoczęciem prac
Zlecenie audytu zaczyna się od decyzji biznesowych, które wyznaczają granice oceny technicznej. Poniższa karta to punkt startowy rozmowy o zakresie.
| Decyzja | Co należy ustalić przed badaniem |
|---|---|
| Co chronimy? | Procesy, dane i operacje, których utrata lub zmiana ma istotne konsekwencje. |
| Co wolno sprawdzić? | Zasoby, role, środowiska, upoważnienie i wpływ testów na usługę. |
| Czego oczekujemy jako dowodu? | Scenariusze, próby dozwolone i zabronione, zapis wyniku oraz jawne ograniczenia. |
| Kto reaguje? | Właściciel decyzji, wykonawca naprawy, kontakt awaryjny i zastępstwo. |
| Kiedy wracamy do działania? | Wymagany czas odtworzenia i kryteria poprawnego procesu biznesowego. |
| Jak odbieramy usługę? | Zakres raportu, przegląd jakości, warunki retestu i decyzje o ryzykach otwartych. |
Rozdział 1Co chroni audyt bezpieczeństwa?
Bezpieczeństwo strony opisują cztery właściwości: poufność danych, poprawność informacji i operacji, dostępność usług oraz możliwość ustalenia, co wydarzyło się w systemie. W praktyce chodzi o ochronę danych klientów, zamówień, dostępu administracyjnego i ciągłości działania. Sama kontrola kodu nie wystarczy, jeśli nikt nie sprawdza uprawnień, nie odbiera alarmów albo nie potrafi odtworzyć bazy danych.[1][23][39]
Dobrym punktem wyjścia jest nazwanie zdarzeń, których organizacja nie akceptuje. W witrynie usługowej może to być podmiana numeru telefonu i przechwytywanie zapytań. W sklepie może to być nieuprawniony odczyt faktur, zmiana rachunku do płatności albo utrata historii zamówień. W portalu klienta chodzi o przekroczenie granicy między kontami różnych firm. To przykładowe scenariusze do rozważenia. Ich znaczenie trzeba ocenić dla konkretnej strony.
Każdy serwis wymaga własnego zakresu audytu. Strona prezentacyjna bez logowania wymaga innego doboru kontroli niż sklep z integracją magazynową, subskrypcjami i wieloma rolami pracowników. Zakres wynika z funkcji serwisu, przetwarzanych danych, architektury i skutków błędu. Liczba pozycji w standardowej ofercie nie jest dobrą miarą.[6]
Audyt warto oddzielić od usuwania skutków trwającego włamania. Przy oznakach aktywnego przejęcia pierwszym celem staje się ograniczenie incydentu, zachowanie potrzebnych dowodów i odzyskanie kontroli. Zaplanowany przegląd bezpieczeństwa nie powinien opóźniać tych działań.[39]
Rozdział 2Co mówią statystyki i jak je czytać
Według raportów Patchstack w ekosystemie WordPressa ujawniono 7 966 nowych podatności w 2024 r. i 11 334 w 2025 r. To wzrost o około 42%. Edycja raportu oznaczona jako „2026” opisuje dane za poprzedni pełny rok. Liczby dotyczą ujawnionych podatności i nie opisują skutecznych włamań.[3][4]
W danych za 2025 r. 91% nowych podatności dotyczyło wtyczek, a 46% podatności nie miało poprawki producenta w chwili publicznego ujawnienia. To dwa różne wskaźniki. Pierwszy opisuje umiejscowienie luk, drugi termin dostępności naprawy. Nie należy ich sumować ani przedstawiać jako prawdopodobieństwa przejęcia witryny. Oba dotyczą zbioru opisanego w raporcie. Nie wynika z nich, że 91% wtyczek jest podatnych ani że zaatakowano 46% stron.[4]
Patchstack jest dostawcą rozwiązań bezpieczeństwa i uczestniczy w procesie zgłaszania podatności. Jego dane trzeba czytać razem z metodologią i zakresem obserwacji. Sam wzrost liczby ujawnień nie dowodzi proporcjonalnego wzrostu ryzyka pojedynczego serwisu. Może też odzwierciedlać intensywność badań i lepsze wykrywanie problemów.[3][4]
W szerszym kontekście: NASK podał, że CERT Polska otrzymał w 2025 r. 658 320 zgłoszeń i zarejestrował 260 783 unikalne incydenty bezpieczeństwa. Dane dotyczą różnych zagrożeń, a WordPress i strony internetowe są tylko jednym z obszarów. Nie obejmują też wszystkich incydentów, które wydarzyły się w Polsce.[5][79]
Wniosek praktyczny jest prosty. Właściciel serwisu potrzebuje wiarygodnego spisu komponentów, procesu śledzenia podatności i możliwości reagowania także wtedy, gdy producent nie wydał jeszcze poprawki. Statystyka pomaga uzasadnić taki proces. Diagnozę konkretnej instalacji trzeba przeprowadzić osobno.[9]
Rozdział 3Skan, audyt i pentest to różne usługi
W tym artykule audyt bezpieczeństwa oznacza uporządkowaną ocenę uzgodnionych zabezpieczeń technicznych i organizacyjnych. Skan podatności zbiera sygnały za pomocą narzędzi. Test penetracyjny sprawdza w kontrolowanych warunkach, czy daną słabość da się wykorzystać. Usługi mogą się uzupełniać, a ich nazwy nie przesądzają o zakresie.[1][2]
| Rodzaj pracy | Na jakie pytanie odpowiada? | Najważniejsze ograniczenie |
|---|---|---|
| Skan podatności | Jakie znane problemy i nieprawidłowości sygnalizuje narzędzie? | Alert wymaga interpretacji. Brak alertów nie dowodzi poprawności procesów. |
| Audyt konfiguracji i procesów | Czy uzgodnione zabezpieczenia są wdrożone i mają dowody działania? | Skuteczność zabezpieczeń trzeba potwierdzić sprawdzeniem w praktyce. |
| Test penetracyjny | Czy określoną słabość można wykorzystać w uzgodnionych warunkach? | Wynik zależy od czasu, dostępów, scenariuszy i wyłączeń. |
| Retest | Czy wskazane problemy zostały skutecznie naprawione? | Obejmuje wskazane problemy. Ponowne badanie całego serwisu to osobny zakres. |
Tabela porządkuje sposób zamawiania usługi. Szczegółowe definicje i granice powinny znaleźć się w uzgodnionym zakresie prac.
Dobrym odniesieniem są OWASP ASVS 5.0.0 i OWASP WSTG 4.2. ASVS pomaga określić wymagania wobec zabezpieczeń, a WSTG zaplanować scenariusze ich sprawdzania. Raport powinien wskazywać wersję, wybrane wymagania oraz odstępstwa. Hasło „zgodnie z OWASP” bez mapowania zakresu niewiele mówi o rzeczywiście wykonanej pracy.[1][2]
Poziom dostępu i jakość badania to osobne kwestie. Test zewnętrzny bez kont pokazuje inną perspektywę niż test z kontami klientów i pracowników. Przegląd kodu i konfiguracji może ujawnić przyczyny, których nie da się wiarygodnie rozpoznać z zewnątrz. Profesjonalna oferta opisuje te różnice i jasno mówi, czego nie da się ocenić po podaniu samego adresu strony.
Rozdział 4Najpierw zasady testów, potem narzędzia
Proponowana karta zakresu wskazuje domeny, subdomeny, środowiska, role, integracje, osoby kontaktowe i godziny prowadzenia prac. Trzeba ustalić, kto może udzielić upoważnienia do testowania poszczególnych zasobów, jak zostanie zgłoszone zagrożenie krytyczne i kiedy audytor ma przerwać badanie. Upoważnienie od właściciela sklepu nie daje automatycznie prawa do testowania infrastruktury operatora płatności.
Osobno warto uzgodnić działania, które mogą zmienić dane lub obciążyć usługę: tworzenie zamówień, wysyłanie wiadomości, przesyłanie plików, sprawdzanie limitów i testy równoległych operacji. Próby odporności na przeciążenie, socjotechnika i masowe pobieranie danych wymagają wyraźnego opisu w zakresie prac. Nie powinny pojawiać się jako nieopisany dodatek do standardowego audytu. Najlepiej pracować na kontach i danych testowych, kontrolując możliwy wpływ na produkcję.
Środowisko testowe ogranicza część ryzyka operacyjnego. Wynik nie przenosi się jednak na produkcję bezwarunkowo. Inne reguły CDN, wersje bibliotek, klucze, uprawnienia czy ustawienia cache mogą zmieniać zachowanie zabezpieczeń. W proponowanym modelu różnice między środowiskami zapisuje się w raporcie, a wdrożone poprawki potwierdza w uzgodnionym zakresie produkcyjnym.
Równie ważne jest bezpieczeństwo samego audytu. Zalecany standard współpracy obejmuje indywidualne konta z datą wygaśnięcia, kontrolowany kanał przekazania dostępów, minimalizację danych w dowodach i ustalony termin usunięcia materiałów. Raport nie powinien zawierać kompletnych tokenów, haseł ani zbędnych danych klientów. Zasady ochrony informacji uwierzytelniających i ograniczania danych w logach opisują odpowiednio dokumenty OWASP Secrets Management i Logging.[21][23]
Kontrakt operacyjny audytu: warunki rozpoczęcia i przerwania prac
Proponowany warunek rozpoczęcia obejmuje potwierdzone upoważnienie, gotowy kontakt awaryjny, sprawdzone konta testowe oraz zatwierdzony sposób odtworzenia danych, jeśli próby mogą je zmienić. Osobno ustala się limity ruchu i operacji, postępowanie przy nieoczekiwanym dostępie do danych oraz zasady kontynuowania prac po wykryciu aktywnego incydentu. Sam dokument zamówienia nie ogranicza ryzyka operacyjnego, jeśli brakuje osób zdolnych zareagować.
Warunek przerwania powinien być obserwowalny: nieuzgodniona degradacja usługi, kontakt z prawdziwymi danymi poza próbą, nieprzewidziana operacja finansowa albo sygnał przejęcia. Audytor zapisuje zdarzenie i przechodzi na uzgodniony kanał eskalacji. Prace wznawia się wyłącznie po decyzji osoby uprawnionej. To proponowane zasady współpracy, które trzeba dostosować do środowiska.
Materiał warto podzielić na dwie części: chronione dowody techniczne i raport dla szerszego grona. Przy każdym dowodzie zapisujemy autora, czas pozyskania, zakres redakcji i miejsce przechowywania. Dla istotnych plików można utrwalić skrót kryptograficzny, który pozwoli wykryć późniejsze zmiany. Taki rejestr pomaga kontrolować integralność materiałów. Sam w sobie nie przesądza o ich wartości w postępowaniu prawnym.
Rozdział 5Model zagrożeń: droga do szkody jako punkt wyjścia audytu
Model zagrożeń porządkuje przepływy informacji, granice zaufania i miejsca podejmowania decyzji. W przypadku strony na WordPressie wykracza poza prosty diagram „przeglądarka → serwer”. Obejmuje również panel hostingu, skrzynkę używaną do odzyskiwania dostępów, repozytorium, skrypty zewnętrzne, kopie i integracje.[6]
Poniższe przykłady pokazują, jak przełożyć model na pytania audytowe. Są to scenariusze przykładowe i nie opisują ujawnionych incydentów.
| Przykładowa droga do szkody | Pytanie, które powinno paść podczas audytu |
|---|---|
| Przejęcie skrzynki → reset hasła → dostęp do hostingu | Czy odzyskiwanie kont technicznych ma adekwatne zabezpieczenia? |
| Błąd w eksporcie → odczyt danych innego klienta | Czy każda operacja sprawdza uprawnienia do konkretnego obiektu? |
| Zmieniony skrypt marketingowy → niepożądane działanie w przeglądarce | Kto może publikować skrypty i jak zatwierdza się zmiany? |
| Przejęte konto serwera → usunięcie aplikacji i kopii | Czy kopie pozostają dostępne po utracie środowiska produkcyjnego? |
| Błąd powiadomienia o płatności → nieprawidłowy status zamówienia | Czy sklep weryfikuje transakcję po stronie serwera? |
Takie podejście zmienia kolejność prac. Najpierw można zbadać proces, którego błąd ujawni dane klientów lub uniemożliwi sprzedaż. Kilkadziesiąt drobnych odstępstw konfiguracyjnych przychodzi na dalszym etapie. To proponowany sposób priorytetyzacji scenariuszy. Podstawowe zabezpieczenia nadal trzeba sprawdzić.
Rozdział 6Łańcuchy zagrożeń: gdy kilka słabości tworzy jeden poważny scenariusz
Lista podatności odpowiada na pytanie, co jest nieprawidłowe. Model łańcucha zagrożenia pokazuje dodatkowo, jakie warunki muszą wystąpić, aby nieprawidłowość doprowadziła do szkody. OWASP wskazuje drzewa ataku jako technikę analizy wieloetapowych scenariuszy, a przypadki nadużycia jako sposób badania niewłaściwego wykorzystania prawidłowego procesu. Obie techniki uzupełniają kontrolę pojedynczych funkcji, która pozostaje podstawą badania.[6]
Zależności między słabościami i ocena CVSS
W proponowanym modelu ścieżka zaczyna się od uprawnienia lub punktu wejścia, przechodzi przez konkretną granicę zaufania i kończy skutkiem biznesowym. Każde połączenie wymaga wyjaśnienia: czy zostało potwierdzone, wynika z konfiguracji, czy pozostaje hipotezą? Dwie słabości w tej samej instalacji nie tworzą automatycznie działającego łańcucha. Nie należy też sumować ich ocen CVSS i przedstawiać wyniku jako nowej oceny podatności.
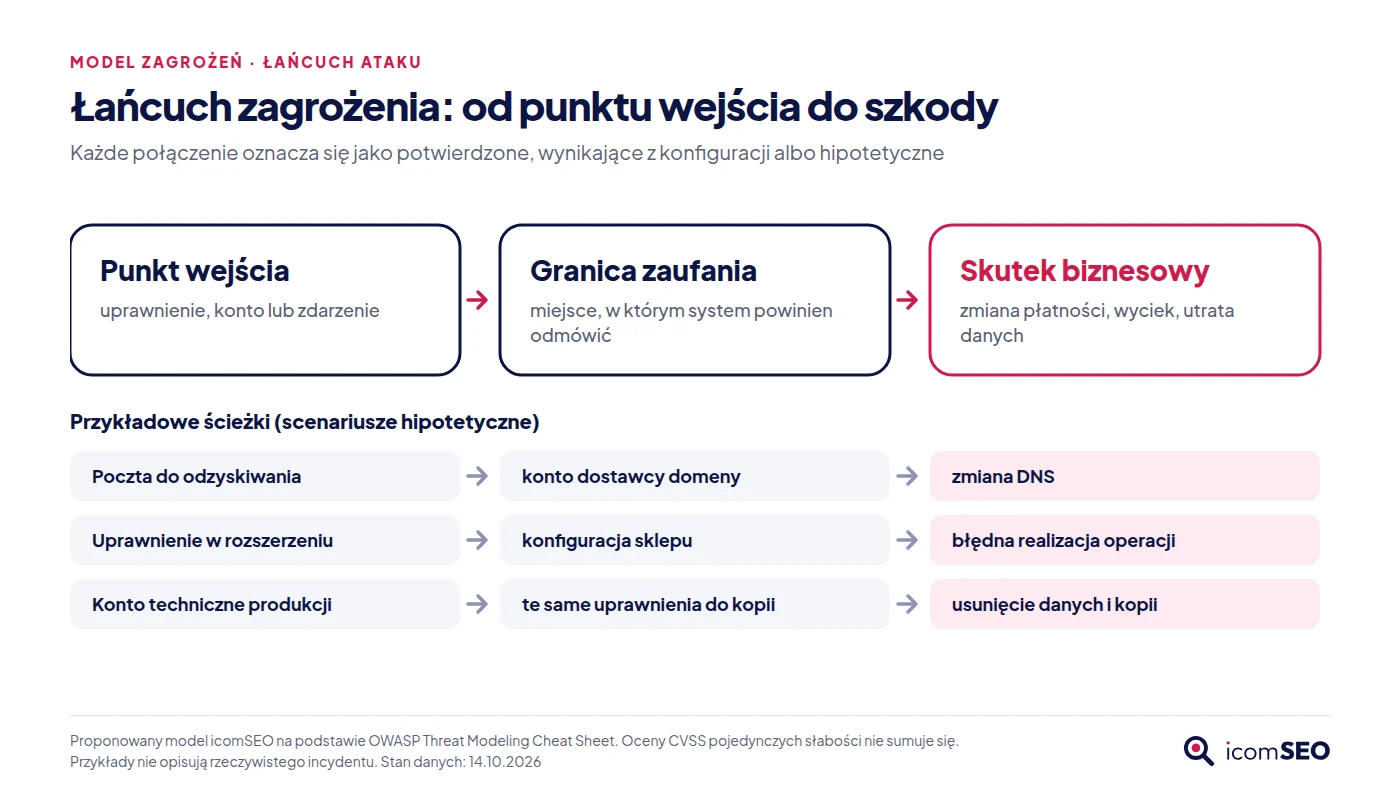
Przykład modelowy: konto redaktora może zmieniać określony fragment strony. Zmiana odbiorcy płatności wykracza poza jego rolę. Jeżeli rozszerzenie pozwala temu kontu zapisać ustawienia integracji, audyt musi ustalić trzy rzeczy: czy zmiana jest rzeczywiście możliwa, czy wymaga dodatkowej zgody i czy system użyje jej przy kolejnej transakcji. Samo wyświetlenie panelu nie potwierdza skutku. Prawdziwa płatność nie jest potrzebna, jeżeli uzgodnione środowisko testowe i kontrola stanu pozwalają bezpiecznie wykazać naruszenie reguły.
| Model ścieżki (scenariusz hipotetyczny) | Co trzeba rozstrzygnąć | Dowód ograniczenia skutku |
|---|---|---|
| Dostęp do poczty odzyskiwania → odzyskanie konta dostawcy → zmiana DNS. | Czy istnieje dodatkowa weryfikacja i czy ta sama osoba kontroluje wszystkie etapy? | Kontrolowany test procesu odzyskiwania oraz blokady lub zatwierdzenia zmiany. |
| Niewłaściwe uprawnienie w rozszerzeniu → zmiana konfiguracji sklepu → błędna realizacja operacji. | Czy uprawnienie pozwala zapisać zmianę i czy system używa jej w procesie? | Odmowa zapisu dla niedozwolonej roli i brak zmiany stanu biznesowego. |
| Konto techniczne produkcji → usunięcie danych → usunięcie kopii dostępnych tym samym kontem. | Czy kopie mają niezależną kontrolę dostępu i ochronę przed usunięciem? | Przegląd uprawnień i bezpieczna próba na wydzielonym zasobie testowym. |
Te przykłady służą do planowania badań. Nie są instrukcją ataku na cudzą infrastrukturę ani twierdzeniem, że wskazane zależności występują w każdej witrynie. Dalsze kroki wolno potwierdzać wyłącznie w granicach upoważnienia. Gdy dostawca zewnętrzny pozostaje poza zakresem, raport nazywa tę granicę i oznacza ścieżkę jako przetestowaną częściowo.
Wspólna przyczyna może wyłączyć kilka zabezpieczeń naraz
Trzy warstwy ochrony nie muszą oznaczać trzech niezależnych barier. Rozważmy hipotetyczny serwis, w którym jedno konto administracyjne może usunąć aplikację, jej kopie oraz historię alarmów. W takim modelu dodatkowa kopia i dodatkowy panel nie usuwają wspólnego punktu zależności. Ten wniosek wynika z uprawnień w opisanym scenariuszu i dotyczy tylko tego scenariusza, bez uogólniania na wszystkie hostingi.
W badaniu sprawdzamy istnienie zapasowego zasobu oraz niezależność jego odzyskania. Kto zna dane dostępowe? Gdzie znajduje się drugi składnik? Czy odzyskanie konta wymaga działającej poczty w tej samej domenie? Czy zespół ma prawo skorzystać z kopii po utracie głównego dostawcy? Odpowiedzi na te pytania trafiają do dokumentacji zależności, obok nazw zakupionych usług.
Wybierz miejsce przerwania ścieżki i sprawdź skutek uboczny
Dla istotnej ścieżki należy wskazać barierę zapobiegającą, sygnał wykrycia i sposób ograniczenia szkody. To trzy różne zadania. Alarm nie cofa ujawnienia danych, a kopia zapasowa nie naprawia utraty ich poufności. Blokada całej integracji może z kolei ograniczyć ekspozycję i jednocześnie zatrzymać zamówienia. Dlatego w proponowanym raporcie rekomendacja opisuje oczekiwany efekt ochronny oraz wpływ na usługę.
Przy odbiorze poprawki warto wrócić do całej ścieżki. Naprawienie pierwszej zaobserwowanej drogi dostępu nie potwierdza, że ten sam skutek jest niedostępny przez eksport, zadanie w tle albo inne konto techniczne. Raport kończy się wtedy precyzyjnym zdaniem: „Przerwano wskazaną ścieżkę w zbadanych wariantach”. Takie sformułowanie lepiej odpowiada zakresowi dowodu niż bezwarunkowe „usunięto ryzyko”.
Rozdział 7Jak dobrać głębokość badania do modelu działania strony
Najłatwiej kupić zbyt mały audyt wtedy, gdy zakres opisano wyłącznie nazwą technologii. „Strona na WordPressie” może oznaczać wizytówkę, wielojęzyczny sklep, portal z dokumentami klientów albo system obsługujący wiele organizacji. Proponujemy najpierw określić profil funkcjonalny serwisu i dopiero do niego dobrać dostęp, próbę testową oraz wymaganą szczegółowość dowodów.
| Profil serwisu | Najważniejsze scenariusze do uwzględnienia | Warunek sensownego badania |
|---|---|---|
| Strona usługowa i pozyskiwanie zapytań | Podmiana kontaktu, przejęcie formularzy, dostęp do zgłoszeń, utrata domeny. | Rozpoznanie HTML strony głównej oraz poczty, hostingu i odbiorców danych. |
| Sklep WooCommerce | Izolacja zamówień, autentyczność płatności, zwroty, dostęp do produktów i spójność odtwarzania. | Konta różnych ról, dane testowe oraz uzgodnienia dotyczące integracji i rozliczeń. |
| Portal klienta lub sprzedaż B2B | Rozdzielenie firm, dokumentów, indywidualnych cen i uprawnień pracowników. | Macierz organizacja–użytkownik–obiekt–operacja oraz reprezentatywne konta z dwóch organizacji. |
| Sieć witryn lub rozbudowane integracje | Wspólne konta, centralne aktualizacje, rozprzestrzenienie awarii i dostęp między systemami. | Mapa zależności, właścicieli oraz granic administracyjnych i technicznych. |
Tabela służy do planowania badania. Wybór poziomu i zestawu wymagań ASVS trzeba uzasadnić odrębnie. Test kilku wymagań poziomu drugiego nie uprawnia do deklaracji, że cała aplikacja spełnia ten poziom.[1]
Granice zaufania: kto może zmienić stronę bez logowania do WordPressa?
Przed testami warto przejść całą drogę: od rejestratora i poczty odzyskiwania dostępu, przez DNS, CDN i hosting, aż do repozytorium i narzędzia publikującego tagi marketingowe. Na każdym etapie zadajemy to samo pytanie: czy przejęcie tego konta pozwoli zmienić treść, przekierować ruch, odczytać dane lub wyłączyć zabezpieczenia? To zastosowanie modelowania zagrożeń do konkretnej architektury. Samo pytanie nie zakłada, że którykolwiek z tych elementów jest podatny.[6]
W proponowanym raporcie każda zależność ma właściciela i oceniony zakres. Jeżeli agencja nie otrzymała dostępu do menedżera tagów, dokument wskazuje ten brak, a skrypty checkoutu pozostają oznaczone jako niezweryfikowane. Jeżeli DNS obsługuje inna firma, ustalenie dotyczące zmian rekordów trafia do właściwej osoby. Lista zależności jest użyteczna dopiero wtedy, gdy prowadzi do działania.
Próba testowa i ograniczenia wnioskowania
Dwa konta klientów pozwalają sprawdzić konkretną granicę dostępu. Nie reprezentują jednak automatycznie wszystkich relacji w sklepie B2B. Należy uwzględnić role, stany zamówienia, typy plików, różne organizacje i alternatywne kanały dostępu. Przy dużej liczbie podobnych funkcji proponujemy uzasadnić dobór próby i powiązać ją ze wspólnym mechanizmem zabezpieczenia. Gdy funkcje używają różnych implementacji, podobny wygląd interfejsu nie wystarcza do wspólnego wniosku.
Raport powinien rozdzielać test wykonany, przegląd konfiguracji i deklarację dostawcy. Gdy nie da się rozstrzygnąć istotnej właściwości, poprawnym wynikiem jest „nie zweryfikowano” z opisem potrzebnego następnego kroku. Brak dostępu nie dowodzi ani podatności, ani bezpieczeństwa.
Rozdział 8Elementy techniczne do zbadania
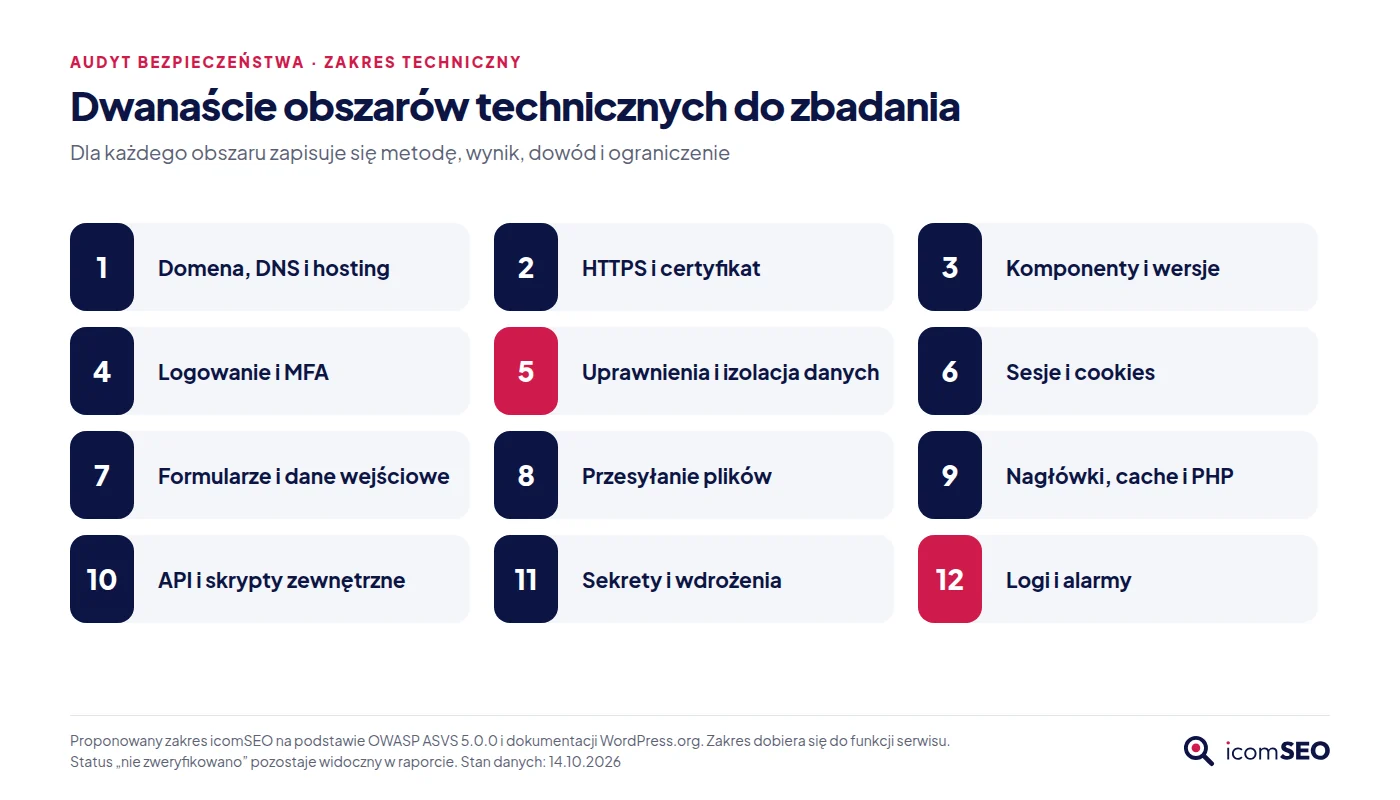
Poniższy zakres jest punktem wyjścia. Dla każdego obszaru warto zapisać zastosowaną metodę, wynik, dowód i ograniczenie. Status „nie zweryfikowano” powinien pozostać widoczny. Brak odpowiednich dostępów nie uzasadnia zmiany tego statusu na „spełniono”.
Domena, DNS, hosting i granice odpowiedzialności
Należy ustalić właściciela konta u rejestratora, osoby uprawnione do zmiany DNS, sposób odzyskiwania dostępu oraz odpowiedzialność za odnowienie domeny. Proponowana inwentaryzacja obejmuje wersje testowe, nieużywane subdomeny, dodatkowe instalacje, publiczne archiwa i panele administracyjne. Dokumentacja WordPressa podkreśla potrzebę rozdzielenia odpowiedzialności dostawcy hostingu od odpowiedzialności za aplikację.[7]
Oczekiwany dowód: mapa zasobów i właścicieli, wynik przeglądu kont oraz lista wyłączeń. Samo stwierdzenie, że hosting jest „zarządzany”, nie wyjaśnia, kto aktualizuje wtyczki, reaguje na infekcję i odtwarza zamówienia. Te zadania należy przypisać wprost.
HTTPS i certyfikat: ochrona całej ścieżki połączenia
Kontrola obejmuje zgodność certyfikatu z domeną, łańcuch zaufania, termin ważności, odnawianie, obsługiwane wersje TLS, przekierowania z HTTP i zasoby ładowane bez szyfrowania. W architekturze z CDN lub proxy trzeba sprawdzić także odcinek między pośrednikiem a serwerem źródłowym. Certyfikat chroni transmisję. Poprawność aplikacji wymaga osobnej oceny.[8]
Oczekiwany dowód: wyniki dla reprezentatywnych nazw hostów, konfiguracja odnawiania i zweryfikowany odbiorca alarmów. HSTS, zwłaszcza z objęciem subdomen, należy włączać po analizie zależności. Mechaniczne skopiowanie restrykcyjnego ustawienia może odciąć dostęp do niedostosowanej usługi.[8][18]
Komponenty, wersje i podatności
Spis obejmuje system zarządzania treścią, wtyczki, motywy, biblioteki i dostępne do oceny składniki środowiska. Trzeba ustalić ich źródło, wersję, właściciela, wsparcie i znane problemy. Przy każdym numerze CVE trzeba też ustalić, czy podatna funkcja jest obecna i dostępna w badanej konfiguracji.[9]
Oczekiwany dowód: powiązanie komponentu z ustaleniem i decyzją: aktualizacja, wymiana, wyłączenie albo czasowe ograniczenie ryzyka. Brak poprawki wymaga odrębnego planu. Zabezpieczenie zastępcze powinno mieć właściciela i termin ponownej oceny, aby nie stało się rozwiązaniem bezterminowym.[9]
Logowanie, MFA i odzyskiwanie dostępu
Należy zbadać mechanizm logowania, ograniczanie automatycznych prób, uwierzytelnianie wieloskładnikowe oraz rejestrowanie zdarzeń. Trzeba sprawdzić również możliwość odzyskania konta po utracie drugiego składnika. MFA nie rozwiązuje problemu, jeśli procedura awaryjna pozwala je łatwo ominąć. Kontrola obejmuje konta administracyjne w całym łańcuchu zarządzania, łącznie z panelem WordPressa.[10][11]
Reset hasła wymaga osobnego scenariusza: czasu ważności i jednorazowości tokenu, poprawnego powiązania z użytkownikiem oraz ochrony przed ujawnieniem informacji o kontach. Oczekiwany dowód: wynik prób pozytywnych i negatywnych. Sam zrzut ekranu z włączoną opcją MFA nie jest dowodem.[61]
Uprawnienia i izolacja danych
Najważniejsze pytanie brzmi: „czy użytkownik może wykonać tę operację na tym obiekcie?”. Samo zalogowanie nie rozstrzyga tej kwestii. Kontrola obejmuje odczyt, zapis, pobieranie i eksport, zarówno między różnymi rolami, jak i między dwoma kontami o tej samej roli. Decyzja o dostępie musi obowiązywać po stronie serwera, dlatego sprawdzenie samego menu panelu nie wystarcza.[12]
Oczekiwany dowód: macierz ról i obiektów oraz próby odmowy dostępu wykonane na danych testowych. Dla faktur, dokumentów i zamówień warto osobno zbadać dostęp przez panel, bezpośredni adres pliku i API. Złożony identyfikator dokumentu nie zastępuje właściwego mechanizmu kontroli.[12]
Sesje, cookies i operacje w imieniu użytkownika
Badanie obejmuje czas ważności sesji, unieważnianie po wylogowaniu, reakcję na zmianę uprawnień i zasady działania na wielu urządzeniach. Atrybuty cookies, takie jak Secure, HttpOnly i SameSite, ocenia się w kontekście rzeczywistych przepływów aplikacji, ponieważ poszczególne ciasteczka pełnią różne funkcje.[13]
Dla operacji zmieniających stan trzeba dodatkowo sprawdzić ochronę przed CSRF, czyli wymuszeniem działania w sesji użytkownika. SameSite może być jedną z warstw ochrony. To, czy wystarcza wobec mechanizmów wymaganych przez aplikację, rozstrzyga analiza. Oczekiwany dowód: kontrolowane próby bez właściwego potwierdzenia operacji oraz wynik po zakończeniu sesji.[58]
Formularze, dane wejściowe i generowanie odpowiedzi
Audyt obejmuje formularze kontaktowe, wyszukiwarki, komentarze, pola profilu, importy i parametry API. Przy SQL injection sprawdza się, czy dane użytkownika mogą zmienić znaczenie zapytania do bazy. Przy XSS sprawdza się, czy nieuprawniona treść może zostać wykonana jako kod w przeglądarce. Ochrona wymaga właściwej obsługi danych. Filtrowanie kilku podejrzanych znaków tego wymogu nie spełnia.[14][15]
W funkcjach pobierających zasoby z podanego adresu należy uwzględnić SSRF, czyli możliwość nakłonienia serwera do połączeń z usługami nieprzeznaczonymi dla użytkownika. Oczekiwany dowód: udokumentowane zachowanie funkcji oraz minimalna demonstracja na kontrolowanych danych, bez pobierania rzeczywistych baz i sekretów.[16]
Przesyłanie plików i prywatne dokumenty
Kontrola obejmuje dozwolone typy plików, weryfikację ich zawartości, limity rozmiaru, bezpieczne nazewnictwo, lokalizację przechowywania i możliwość wykonania kodu. Osobno trzeba sprawdzić pobieranie dokumentów, bo plik poprawnie przyjęty przez formularz nadal może zostać niewłaściwie udostępniony. Samo ukrycie przycisku pobierania nie chroni zasobu.[17]
Oczekiwany dowód: macierz plików dopuszczonych i odrzucanych, próby odczytu między kontami oraz weryfikacja sposobu serwowania zawartości. Dla dokumentów prywatnych należy ustalić, czy istnieje autoryzowany dostęp lub odpowiednio ograniczony mechanizm czasowych odnośników. Trudny do odgadnięcia adres nie powinien być jedyną ochroną.[17]
Nagłówki, cache i konfiguracja PHP
Content-Security-Policy, ochrona przed osadzaniem strony w ramce, zasady przekazywania informacji o stronie odsyłającej i nagłówki typów treści wymagają dopasowania do serwisu. Obecność nagłówka nie oznacza, że jego wartość daje zamierzony efekt. Audyt uwzględnia zgodność ustawień z płatnościami, formularzami i zewnętrznymi zasobami.[18]
Cache należy sprawdzić pod kątem rozdzielenia treści publicznych i prywatnych. Nieprawidłowe reguły pośrednika mogą udostępnić odpowiedź przygotowaną dla innego użytkownika. W PHP istotne są m.in. ujawnianie błędów, konfiguracja sesji, obsługa plików i ograniczenia zasobów. Oczekiwany dowód: testy odpowiedzi dla różnych stanów logowania i przegląd ustawień środowiska, które faktycznie działa.[59][60]
API, integracje i skrypty zewnętrzne
Dla API należy zbadać uwierzytelnianie, uprawnienia, zakres zwracanych danych, limity i obsługę błędów. Kontrola obejmuje również starsze wersje interfejsów, które mogą nadal pozostawać aktywne. W integracjach najważniejsze są tożsamość nadawcy, minimalne uprawnienia i możliwość odwołania dostępu bez wyłączania całego serwisu.[19][21]
Skrypty analityczne, czaty, systemy reklamowe i menedżery tagów stają się częścią środowiska przeglądarki użytkownika. Trzeba więc znać ich pochodzenie, właścicieli kont i procedurę publikacji zmian. Oczekiwany dowód: rejestr integracji z celem, zakresem dostępu, odbiorcą danych i osobą odpowiedzialną za utrzymanie.[20]
Sekrety, repozytoria i proces wdrażania
Hasła techniczne, tokeny i klucze API nie powinny trafiać do publicznych plików, logów ani pakietów udostępnianych użytkownikom. Kontrola obejmuje ich przechowywanie, wydawanie, ograniczenie dostępu i unieważnianie. Usunięcie sekretu z aktualnego pliku nie wystarcza, jeżeli wcześniejsza wartość została ujawniona i nadal działa.[21]
W procesie wdrażania należy sprawdzić dostęp do repozytorium, zatwierdzanie zmian, uprawnienia automatyzacji oraz rozdzielenie środowisk. Oczekiwany dowód: możliwość ustalenia, kto wdrożył konkretną wersję, z jakiego źródła i po jakich testach. Szczególnie istotne są konta techniczne, które mogą publikować kod na produkcji.[22]
Logi, alarmy i reakcja operacyjna
Warto zbadać rejestrowanie logowań, zmian ról, instalacji dodatków, zmian konfiguracji i operacji na danych. Logi powinny wiązać zdarzenie z czasem, kontem i zasobem. Nie powinny przy tym bez potrzeby gromadzić haseł, tokenów ani pełnych danych transakcji. Należy ocenić również ich ochronę, dostęp i okres przechowywania.[23]
Oczekiwany dowód: kontrolowane zdarzenie testowe, zapis w odpowiednim źródle i potwierdzenie, że alarm dotarł do osoby odpowiedzialnej. W proponowanym modelu mierzy się całą drogę od zdarzenia do reakcji. Sam panel z wykresem nie mówi, czy ktoś otrzyma powiadomienie poza godzinami pracy.
Głębsza kontrola infrastruktury: dostęp do serwera źródłowego i ruch wychodzący
W rozszerzonym zakresie należy sprawdzić, czy konfiguracja CDN lub WAF odpowiada faktycznej ścieżce do aplikacji. Kontrola obejmuje zatwierdzone interfejsy i zasady dostępu do serwera źródłowego, zgodność konfiguracji dla różnych domen oraz uprawnione źródła nagłówków przekazywanych przez proxy. Obecność usługi ochronnej na stronie głównej nie potwierdza ochrony wszystkich udostępnionych kanałów. Ten scenariusz weryfikuje się w konkretnej architekturze, bez założeń o możliwym obejściu zabezpieczeń danego dostawcy.
Osobno warto ocenić połączenia wychodzące: które integracje faktycznie wymagają dostępu do internetu, kto zatwierdza adresy odbiorców i jakie ograniczenia mają procesy przetwarzające pliki lub adresy URL. Testy wykonuje się wobec uzgodnionych, kontrolowanych usług, bez prób dostępu do obcych systemów. Dowodem są zasady dostępu, wynik dozwolonego połączenia oraz wynik bezpiecznej próby odmowy w zatwierdzonym zakresie.
CSP: tryb raportujący i tryb blokujący
Content Security Policy może ograniczać źródła wykonywanego kodu i innych zasobów, ale wymaga dopasowania do aplikacji. Nagłówek Content-Security-Policy-Report-Only służy do obserwacji naruszeń i niczego nie blokuje. OWASP opisuje również znaczenie nonce, hashy i ostrożnego doboru dozwolonych źródeł. CSP jest dodatkową warstwą ochrony, a przyczynę XSS i tak trzeba usunąć w aplikacji.[85]
W proponowanym odbiorze zapisujemy tryb polityki, objęte odpowiedzi, scenariusze dopuszczone i zablokowane oraz wpływ na checkout, formularze i narzędzia dostępności. Polityka skopiowana z innej strony może wyglądać restrykcyjnie i jednocześnie blokować właściwe działanie usług. Szerokie wyjątki dodane tylko po to, by zniknęły błędy w konsoli, również wymagają ponownej oceny.
Rozdział 9WordPress: audyt całej instalacji
W WordPressie ryzyko ocenia się dla konkretnego zestawu dodatków, konfiguracji i sposobu utrzymania. Aktualny rdzeń to istotny warunek, a bezpieczeństwo motywu, własnego kodu i integracji trzeba sprawdzić osobno. Dokumentacja projektu zaleca ograniczanie dostępu, korzystanie z zaufanych źródeł, aktualizacje i przygotowanie do odzyskiwania systemu.[7]
Rdzeń, motyw potomny, dodatki premium i kod poza panelem
Inwentaryzacja obejmuje wszystkie komponenty instalacji, także te spoza listy aktywnych wtyczek widocznej na pierwszym ekranie. Należy uwzględnić dodatki nieużywane, motyw nadrzędny i potomny, własne modyfikacje, fragmenty kodu przechowywane przez narzędzia administracyjne oraz komponenty dostarczane przez hosting. Przy dodatkach premium trzeba ustalić źródło aktualizacji, ważność dostępu do poprawek i osobę odpowiedzialną za ich wdrażanie.[7][9]
Osobnej uwagi wymagają must-use plugins, czyli dodatki ładowane automatycznie z katalogu mu-plugins. Działają inaczej niż zwykłe wtyczki i nie obejmują ich standardowe powiadomienia o aktualizacjach. Mogą być uzasadnionym elementem konfiguracji hostingu lub własnego rozwiązania. Dlatego przed decyzją o usunięciu należy rozpoznać ich pochodzenie.[27]
Proponujemy, aby rejestr komponentu zawierał nazwę, wersję, źródło, przeznaczenie, opiekuna, status aktualizacji oraz decyzję o dalszym używaniu. Pytanie „czy to potrzebne?” rozstrzyga się wtedy z właścicielem procesu. Odpada też przypadkowe wyłączanie elementów na produkcji.
wp-config.php, debugowanie i możliwość modyfikowania kodu
Przegląd konfiguracji obejmuje ochronę danych połączenia z bazą, kluczy uwierzytelniania, ustawień debugowania i ścieżek zapisu logów. Trzeba sprawdzić także kopie pliku konfiguracyjnego oraz archiwa migracyjne. Problemem może być publicznie dostępna kopia działającego pliku PHP zapisana w innym formacie.[28]
Stałe DISALLOW_FILE_EDIT i DISALLOW_FILE_MODS mają różny zakres. Pierwsza dotyczy edycji kodu w panelu. Druga blokuje modyfikacje szerzej, w tym instalowanie i aktualizowanie. Audyt ocenia je w kontekście procesu wdrażania. Włączenie ograniczenia bez innego sposobu dostarczania poprawek może utrudnić utrzymanie.[28]
Kryterium oceny: uprawnione osoby mają kontrolowany sposób wdrażania zmian, a użytkownicy i procesy niewymagające takiego dostępu nie mogą modyfikować kodu. Raport opisuje rzeczywiste uprawnienia i model pracy. Obecność wybranej stałej jest tylko jednym z elementów tego opisu.
Role i capabilities: kontrola uprawnień do operacji
WordPress przypisuje uprawnienia do określonych czynności, nazywane capabilities. Własne rozszerzenie powinno weryfikować właściwe uprawnienie, np. funkcją current_user_can(), z uwzględnieniem konkretnego zasobu. Samo sprawdzenie nazwy roli albo obecności zalogowanej sesji może nie oddawać właściwej polityki dostępu.[25]
Audyt obejmuje role niestandardowe, delegowane zarządzanie, dostęp wykonawców i skutki zakończenia współpracy. W instalacji wielowitrynowej należy osobno rozważyć uprawnienia na poziomie całej sieci i pojedynczej witryny. Proponujemy, aby wynikiem była uzgodniona macierz: rola, czynność, zasób, dozwolony rezultat i dowód testu.
Nonce i autoryzacja to osobne kontrole
Token nonce w WordPressie pomaga chronić przed określonymi nadużyciami, w szczególności CSRF. Nie służy do nadawania uprawnień. Oficjalna dokumentacja zastrzega też, że nonce nie gwarantuje ochrony przed ponownym użyciem. Dlatego poprawny token nie może samodzielnie uzasadniać odczytu danych, zmiany ustawień ani usunięcia dokumentu.[24]
W praktycznym scenariuszu sprawdza się trzy niezależne warunki: czy rozpoznano użytkownika, czy ma uprawnienie do operacji na wskazanym obiekcie oraz czy żądanie zawiera wymagane potwierdzenie. Kryterium oceny: konto o zbyt małych uprawnieniach nadal otrzymuje odmowę, nawet gdy ma prawidłowy token dla dostępnej mu funkcji.[24][25]
REST API i AJAX: publiczny adres wymaga oceny
WordPress udostępnia publiczne i chronione punkty końcowe API. Dostępność adresu ocenia się w kontekście jego funkcji: audyt sprawdza, czy konkretny endpoint zwraca wyłącznie zamierzone dane i właściwie kontroluje dostęp. Własne endpointy REST wymagają poprawnej implementacji permission_callback. Tę funkcję ocenia się pod kątem tego, co rzeczywiście robi.[26]
Analogicznego przeglądu wymagają operacje AJAX: ich dostępność dla gości i zalogowanych kont, walidacja danych, nonce oraz uprawnienia. Zablokowanie całego REST API lub katalogu administracyjnego bez sprawdzenia zależności może zakłócić działanie serwisu. Kryterium oceny: dopuszczone ścieżki działają, a wszystkie objęte testem nieuprawnione operacje są odrzucane.[7][25][26]
Własny kod: walidacja i bezpieczne wyświetlanie
W audycie kodu należy rozdzielić walidację, czyli sprawdzenie dopuszczalności wartości, od przygotowania danych do bezpiecznego wyświetlenia. Liczba w zamówieniu, adres URL i fragment HTML mają różne wymagania. WordPress udostępnia odpowiednie funkcje, a audyt sprawdza, czy użyto ich we właściwym kontekście.[32][33]
Warto prześledzić przepływ danych od formularza lub API przez zapis w bazie aż do wyświetlenia w panelu i na stronie. Zapisana informacja nie staje się zaufana tylko dlatego, że pochodzi z własnej bazy. Kryterium oceny: aplikacja przyjmuje wyłącznie dopuszczalne wartości, a sposób generowania odpowiedzi nie zamienia danych użytkownika w wykonywany kod.[15][32][33]
Integralność plików i ograniczenia sum kontrolnych
Polecenia WP-CLI, m.in. wp core verify-checksums oraz wp plugin verify-checksums, porównują pliki z dostępnymi sumami kontrolnymi. Pierwsze dotyczy rdzenia, drugie korzysta z sum dla obsługiwanych wtyczek z WordPress.org. Brak dostępnej sumy dla dodatku komercyjnego nie jest dowodem infekcji.[29][30]
Również zgodność sprawdzonych plików nie potwierdza bezpieczeństwa całej instalacji. Wynik badania odnosi się tylko do objętych nim lokalizacji. Baza danych, własny kod i dodatkowe pliki wymagają osobnej kontroli. Oczekiwany wynik: opis sprawdzonych elementów, rozpoznanie uzasadnionych modyfikacji i analiza odstępstw. Jedno polecenie nie daje podstaw do etykiety „czysta strona”.[29][30]
Hasła aplikacji i dostęp integracyjny
Hasła aplikacji służą do udzielania dostępu integracjom niezależnie od zwykłego hasła logowania. Audyt ustala, do kogo należą, jaki system ich używa i czy nadal są potrzebne. Dokumentacja REST API udostępnia m.in. dane o utworzeniu i ostatnim użyciu hasła aplikacji oraz możliwość usunięcia konkretnego hasła.[31]
Kryterium oceny: każdy aktywny dostęp ma rozpoznanego właściciela i uzasadnienie, a jego odwołanie uwzględniono w procedurze zakończenia współpracy. Inwentaryzację wszystkich niezależnych tokenów i kluczy prowadzi się osobno, także po zmianie hasła administratora.
Harmonogramy, zadania w tle i kopie uruchamiane przez wtyczki
WP-Cron sprawdza zaplanowane zadania przy ładowaniu strony, więc działa inaczej niż stale uruchomiony harmonogram systemowy. Ma to znaczenie dla czynności wymagających przewidywalnego wykonania, takich jak synchronizacja czy niektóre mechanizmy tworzenia kopii. Audyt ustala, jaki harmonogram faktycznie uruchamia zadania w badanej instalacji.[62]
Oczekiwany dowód: historia wykonania i kontrola opóźnień, ponieważ sama nazwa zadania w panelu nie potwierdza, że zadanie się wykonuje. Dla procesów krytycznych proponujemy sprawdzenie zachowania po błędzie: ponowienia, alarmu, wpływu na dane i sposobu ręcznego wznowienia pracy.
Multisite, współdzielony hosting i centralne narzędzia utrzymania
W rozszerzonym zakresie warto oddzielić uprawnienia w panelu aplikacji od granic systemowych. Przy kilku instalacjach na jednym koncie hostingowym należy ustalić, czy proces jednej strony może odczytywać lub zmieniać pliki pozostałych. W WordPress Multisite potrzebna jest osobna ocena działań administratora witryny i administratora całej sieci. Samo rozdzielenie adresów domenowych nie jest dowodem izolacji. Są to proponowane scenariusze wynikające z analizy architektury i kontroli między środowiskami.[75]
Przykładowy zakres obejmuje centralny panel zarządzający aktualizacjami, konto techniczne wykonawcy oraz repozytorium kopii. Audytor ustala, ile stron obejmuje pojedynczy dostęp i jak go odwołać. Testy izolacji przeprowadza się wyłącznie na zasobach objętych upoważnieniem. Współdzielony serwer nie daje prawa do badania cudzych witryn.
Zakres hasła aplikacji wynika z uprawnień konta
Hasło aplikacji jest przypisane do użytkownika i służy wyłącznie do dostępu programistycznego. Można je odwołać niezależnie. Ocena musi jednak obejmować również uprawnienia konta, pod którym działa integracja. Nazwanie hasła „tylko raporty” samo w sobie nie ogranicza możliwych operacji.[70]
Proponowany test jest konkretny: integracja pobierająca potrzebny raport działa poprawnie, a próba wykonania nieuzgodnionej operacji zostaje odrzucona. Następnie odwołujemy dostęp testowy i sprawdzamy, czy rzeczywiście przestał działać. Tę samą zasadę warto stosować do automatyzacji, zewnętrznych paneli i narzędzi wykorzystujących AI. Każde z nich wymaga kontroli faktycznie otrzymanych uprawnień, niezależnie od nazwy.
Aktualizacja jako kontrolowana zmiana
Dla każdej krytycznej zależności proponujemy prowadzić krótką kartę: skąd pochodzi kod, kto odpowiada za licencję i aktualizacje, jak sprawdzić poprawność po wdrożeniu oraz jak wycofać nieudaną zmianę. Karta powinna uwzględniać również płatne wtyczki dołączane do motywu, własne moduły i fragmenty kodu wprowadzone poza typowym cyklem publikacji.
Ważne jest porównanie wersji faktycznie uruchomionej z wersją oczekiwaną. Sama informacja o zakończeniu zadania aktualizującego nie dowodzi powodzenia wdrożenia. W proponowanym odbiorze sprawdzamy logowanie, formularze, proces zamówienia i funkcję bezpośrednio dotkniętą zmianą. Cofnięcie plików po migracji struktury bazy wymaga odrębnego planu, bo przywrócenie starego kodu nie musi przywrócić zgodności danych.
WAF i wirtualna poprawka: mierzalne ograniczenie ryzyka
Wirtualna poprawka blokuje określone próby wykorzystania podatności bez zmiany podatnego kodu. Jej skuteczność zależy od tego, czy ruch przechodzi przez kontrolowaną warstwę i czy reguła rozpoznaje dany wariant operacji. W raporcie trzeba odróżniać stan „zablokowano badany scenariusz” od stanu „usunięto podatność”.[73]
W proponowanej karcie zabezpieczenia zastępczego zapisujemy zakres ochrony, wynik testu, dozwolone procesy, termin wygaśnięcia decyzji oraz właściciela trwałej naprawy. Jeżeli ochronę realizuje CDN, warto ocenić również uzgodniony dostęp do serwera źródłowego. Próba dopuszczona w środowisku testowym nie może prowadzić do nieuzgodnionego wyłączania ochrony na produkcji.[73]
Inwentaryzacja techniczna: przykład zbierania danych
Administrator z upoważnionym dostępem może listować komponenty poleceniami WP-CLI. Poniższy przykład zbiera nazwę, stan i wersję. Nie sprawdza kompletnego bezpieczeństwa i nie aktualizuje wtyczek. Pola i format wyniku określa dokumentacja.[87][88]
wp plugin list --fields=name,status,version,update --format=json
wp theme list --fields=name,status,version,update --format=json
Polecenia uruchamia osoba rozumiejąca ich działanie, w poprawnie wskazanym i uzgodnionym środowisku. Służą do odczytu, ale uruchomienie WP-CLI może ładować kod instalacji. Przy podejrzeniu przejęcia nie traktuje się ich więc jako neutralnej analizy nieznanego kodu. Wynik przechowuje się poza publicznym katalogiem strony i wiąże z datą oraz środowiskiem.
Spis uzupełnia się o komponenty spoza typowej listy, źródła dodatków premium, biblioteki w projektach własnych, kod snippetów i osoby odpowiedzialne za utrzymanie. Sumy kontrolne rdzenia oraz dostępnych pakietów są kolejnym źródłem informacji. Zgodność z sumą nie potwierdza jednak braku podatności danej wersji. Brak dostępnej sumy dla dodatku komercyjnego również nie dowodzi infekcji.[29][30]
Rozdział 10WordPress headless i cache: gdzie kończy się ochrona danych?
W architekturze headless WordPress udostępnia dane, a odrębna aplikacja odpowiada za ich prezentację. Audyt musi więc objąć również tę aplikację, sposób budowania stron i warstwy pośrednie. Dokumentacja REST API WordPressa opisuje różne konteksty odpowiedzi i statusy wpisów, w tym treści robocze oraz prywatne. Poprawne zachowanie jednego endpointu nie rozstrzyga, co z pobranymi informacjami zrobi reszta rozwiązania.[92]
Oddziel publikację, podgląd i administrację
Proponowana mapa obejmuje trzy kanały: publiczną publikację, podgląd treści przed publikacją oraz operacje redakcyjne. Dla każdego zapisujemy odbiorcę, sposób uwierzytelnienia, miejsce przechowywania wyniku i zasady jego udostępniania. Przy podglądzie trudność odgadnięcia adresu jest tylko jednym z kryteriów. Trzeba ustalić, czy adres stanowi świadomie zaprojektowany, ograniczony czasowo mechanizm dostępu, czy tylko niepubliczny odnośnik bez kontroli.
Przykład badania: redaktor tworzy oznaczony dokument testowy, ogląda go w podglądzie, a następnie odbiera dostęp do podglądu. Audytor sprawdza odpowiedź API, wynik generowania frontendu, cache CDN oraz zachowanie wcześniej wydanego odnośnika. Oczekiwany wynik ustala się przed testem: dokument ma być niedostępny dla odbiorcy bez uprawnienia, również wtedy, gdy wcześniej prawidłowo obejrzał go redaktor. Przykład nie oznacza, że każda implementacja wymaga identycznego sposobu unieważniania linków.
Cache składa się z kilku mechanizmów
Należy odróżnić pamięć podręczną odpowiedzi HTTP od pamięci obiektowej używanej przez aplikację. Dokumentacja WordPressa opisuje WP_Object_Cache oraz możliwość zastosowania trwałego backendu przez dodatkowe rozwiązanie. Z tego powodu audyt nie zakłada, że zaznaczenie jednej opcji lub wyczyszczenie jednej warstwy usuwa wszystkie wcześniej zapisane dane.[93]
W proponowanym przeglądzie każda warstwa cache ma właściciela, zakres danych i zasadę unieważniania. Przy odpowiedziach przeznaczonych dla konkretnego klienta sprawdzamy, czy sposób identyfikowania zawartości odróżnia odbiorców i konteksty uprawnień. Przy własnym kodzie korzystającym z cache obiektowego analizujemy także podział między witrynami i organizacjami. Wynik dotyczy wyłącznie sprawdzonej implementacji i nie przenosi się automatycznie na wszystkie wtyczki Redis czy Memcached.
| Zmiana stanu w scenariuszu testowym | Co obserwować | Przykładowe kryterium odbioru |
|---|---|---|
| Odczyt dokumentu przez klienta A, następnie żądanie klienta B. | Odpowiedź aplikacji i każdej warstwy pośredniej. | B nie otrzymuje dokumentu A, również z cache. |
| Odebranie uprawnienia po prawidłowym odczycie. | Sesję, API, wcześniej wygenerowany odnośnik i wersję podręczną. | Dalszy dostęp odpowiada uzgodnionej polityce odwołania. |
| Zmiana treści z publicznej na prywatną. | Origin, frontend, CDN i opublikowane artefakty. | Kontrolowane kopie publiczne usunięto, a ograniczenia wobec cudzych kopii opisano. |
| Wdrożenie nowej polityki dostępu. | Zgodność kodu i konfiguracji na wszystkich aktywnych węzłach. | Żaden węzeł nie udostępnia części użytkowników starszego wariantu odpowiedzi. |
Unieważnienie dostępu a kopie już pobrane
Jeżeli odbiorca wcześniej legalnie pobrał dokument, późniejsze odwołanie dostępu nie usuwa pliku z jego urządzenia. Test powinien zatem rozróżniać dalsze pobieranie z systemu od kontroli nad kopią, która jest już poza organizacją. Wymaganie „dokument ma zniknąć wszędzie” jest nieweryfikowalne bez doprecyzowania zakresu i uprawnień. To ograniczenie należy zapisać, szczególnie w portalach B2B i przy dystrybucji materiałów cyfrowych.
Podobnie CORS i kontrola uprawnień API to osobne mechanizmy: reguły przeglądarki i decyzja serwera o dostępie odpowiadają na inne pytania. Własny frontend nie powinien otrzymywać uprzywilejowanego sekretu tylko dlatego, że pochodzi z „naszej strony”. Zakres danych i operacji trzeba egzekwować po stronie zaufanej usługi.[19]
Wynik tej części audytu powinien zawierać mapę odpowiedzi prywatnych, przetestowane zmiany stanu i granice unieważniania. Pojedyncze zalecenie „wyłącz cache dla zalogowanych” wydane bez takiej analizy może okazać się zarazem zbyt szerokie i niewystarczające.
Rozdział 11WooCommerce: testuj pieniądze, dokumenty i stan zamówienia
W sklepie ocenie podlega cały proces sprzedażowy, łącznie z formularzem logowania. Testy logiki biznesowej obejmują m.in. kolejność operacji, ograniczenia liczby wykonań, integralność danych i sytuacje, w których prawidłowe funkcje zostają użyte w niezamierzony sposób. Poniższe scenariusze trzeba dobrać do wdrożonych rozszerzeń i przeprowadzać na uzgodnionych danych testowych.[34]
Ceny, rabaty i zasady naliczania zamówienia
Należy zweryfikować, czy ostateczne ceny i warunki transakcji są ustalane po stronie serwera. Warto sprawdzić łączenie rabatów, limity kuponów, waluty, koszty dostawy i zachowanie po zmianie zawartości koszyka. Miarą jest zgodność wyniku z regułami właściciela sklepu.[34][35]
Proponowane kryterium: klient nie może narzucić niedozwolonej kwoty, a ponowienie lub zmiana kolejności działań nie obchodzą limitów. W scenariuszach równoległych trzeba wcześniej ustalić skalę testu, aby nie zakłócić stanów magazynowych ani zewnętrznych rozliczeń.
Potwierdzanie płatności
Zanim zamówienie zostanie uznane za opłacone, integracja weryfikuje transakcję po stronie serwera, niezależnie od powrotu użytkownika z bramki płatniczej. Sprawdza autentyczność powiadomienia, identyfikator, kwotę, walutę i właściwy status. Ważna jest także odporność na powtórzone komunikaty.[36]
Kryterium oceny: nieprawidłowe lub powielone potwierdzenie nie powoduje niedozwolonej realizacji zamówienia, zwrotu ani ponownego wydania produktu cyfrowego. Szczegóły weryfikacji muszą odpowiadać dokumentacji używanego operatora i wersji integracji. Nie istnieje jedna uniwersalna implementacja dla wszystkich bramek.[36]
Webhooki i synchronizacja z innymi systemami
Webhook przekazuje zdarzenie do innego systemu, np. magazynu lub CRM. WooCommerce pozwala skonfigurować sekret, którym podpisuje się przekazywaną zawartość. Należy sprawdzić odbiorców, przechowywanie sekretów i to, czy system odbierający faktycznie weryfikuje autentyczność komunikatu.[37]
Test powinien uwzględniać także opóźnienie, ponowienie i chwilową niedostępność odbiorcy. Po przywróceniu połączenia stan zamówień powinien pozostać spójny. Dobrą zasadą jest rozdzielenie webhooków wychodzących ze sklepu i powiadomień przychodzących od operatora płatności. Pełnią różne role, więc wspólna konfiguracja wymaga wcześniejszej analizy.
Faktury, zamówienia i dostęp do produktów cyfrowych
Na dwóch kontach testowych warto sprawdzić szczegóły zamówień, historię zakupów, faktury, reklamacje i pliki do pobrania. Osobnej oceny wymagają zamówienia gościnne oraz odnośniki przesyłane pocztą. Parametry dostępu muszą odpowiadać przeznaczeniu funkcji: dokument księgowy wymaga silniejszej ochrony niż zwykły publiczny załącznik.[12][17]
Proponowane kryterium: uzasadnione scenariusze klienta działają, a żadna inna ścieżka nie daje dostępu do cudzego zasobu. Dane techniczne w raporcie powinny pochodzić z kont testowych i nie zawierać rzeczywistych faktur klientów.
Zwroty, pracownicy i klucze API
Należy ustalić, kto może zwracać środki, zmieniać dane płatności, eksportować klientów i tworzyć dostęp integracyjny. Ustawienia zaawansowane WooCommerce pozwalają zarządzać kluczami REST API przypisanymi do użytkowników i określać ich uprawnienia. To obszar kontroli odrębny od kont zwykłych kupujących.[38]
Proponowany wynik audytu obejmuje macierz uprawnień personelu, listę aktywnych integracji oraz próbę odwołania niepotrzebnego dostępu w kontrolowanych warunkach. Szczególnie ważne jest rozróżnienie osób realizujących zamówienia od osób uprawnionych do zmiany konfiguracji sklepu i systemów płatniczych.
Store API, klasyczny checkout i rozszerzenia blokowe
WooCommerce Store API obsługuje funkcje przeznaczone dla kupujących, m.in. produkty, koszyk i checkout. Jest odrębne od administracyjnego interfejsu WooCommerce REST API. Publiczna dostępność danych katalogowych wynika z projektu. Informacje innych klientów nie powinny być dostępne tą ścieżką. Operacje zapisu mają dodatkowe wymagania opisane w dokumentacji.[68]
Checkout blokowy i własna aplikacja korzystająca z API wymagają testów niezależnych od testu klasycznego formularza. Należy ustalić, które ścieżki działają w produkcji, jak identyfikują koszyk i na jakim etapie sprawdzają uprawnienia. Dowodem jest zgodne zachowanie każdej objętej zakresem ścieżki, również przy zmianie sesji i powtórzeniu operacji.
HPOS i odzyskiwanie poprawnego stanu zamówień
High-Performance Order Storage może przechowywać zamówienia w dedykowanych tabelach, z mechanizmami zgodności i synchronizacji zależnymi od ustawień. Dlatego audyt odtwarzania ustala aktywny model przechowywania oraz zgodność dodatków i na tej podstawie weryfikuje plan kopii. Historyczna lista tabel jest do tego niewystarczająca.[69]
Proponowany test polega na porównaniu kontrolnego zbioru zamówień, pozycji, statusów, kwot i powiązań po odtworzeniu. Sprawdzamy także, czy przywrócona wersja aplikacji rozumie odzyskany schemat danych. Protokół wskazuje, które procesy sprzedażowe odtworzono i uzgodniono z systemami zewnętrznymi, bo poprawne wyświetlenie strony głównej nie potwierdza kompletności sklepu.
Płatności osadzone i PCI DSS: zakres zależy od integracji
PCI DSS to branżowy standard ochrony danych płatniczych. Nie jest przepisem prawa powszechnego i nie przewiduje identycznego audytu dla każdego sklepu. Właściwy sposób wykazania zgodności ustala się z podmiotem przyjmującym taką ocenę, zwykle agentem rozliczeniowym lub właściwą organizacją płatniczą. Samo przekazanie obsługi płatności dostawcy nie rozstrzyga wszystkich warunków dla witryny sprzedawcy.[64]
PCI SSC wyjaśnia w FAQ 1588, że wskazane kryterium SAQ A dotyczące podatności strony na ataki skryptowe odnosi się do osadzonych formularzy lub stron płatności, np. iframe. W tej samej postaci nie stosuje się go do przekierowania na stronę operatora. To rozróżnienie dotyczy określonego kryterium. Nie zwalnia automatycznie z pozostałych wymagań ani z obowiązku bezpiecznej integracji.[64]
W audycie warto więc ustalić, jakie skrypty wykonują się przy checkoucie, kto może je zmienić oraz jak wykrywa się nieautoryzowaną publikację. Wynik opisuje konkretną architekturę i granice oceny. Zwykłego audytu WordPressa nie należy przedstawiać jako formalnej oceny PCI DSS, jeżeli nie obejmuje właściwego zakresu i trybu weryfikacji.
Limity Store API wymagają sprawdzenia
Dokumentacja WooCommerce opisuje ograniczanie liczby żądań Store API jako funkcję opcjonalną oraz osobny zakres ograniczania checkoutu. Jedno ustawienie nie musi chronić wszystkich endpointów, metod i integracji. Przy warstwie proxy znaczenie ma też sposób identyfikowania klienta, dlatego konfigurację porównuje się z faktyczną architekturą.[86]
Proponowany test używa małej, uzgodnionej liczby operacji i kont testowych. Sprawdza zarówno odmowę po przekroczeniu ustalonego limitu, jak i poprawne zachowanie klientów, którzy limitu nie przekraczają. Test nie ma na celu przeciążenia sklepu. Raport wymienia objęte funkcje i wyjątki, co daje więcej informacji niż ogólny wniosek „ochrona przed botami działa”.
Rozdział 12Cykl życia danych: eksport, usuwanie i powrót informacji po odtworzeniu
Ochrona danych obejmuje kontrolę dostępu oraz decyzje o tym, jakie informacje przechowujemy, komu je przekazujemy i kiedy kończymy ich przetwarzanie. RODO przewiduje zasadę ograniczenia przechowywania oraz prawo do usunięcia danych, z określonymi warunkami i wyjątkami. Usunięcie konta wymaga więc ustalenia, które dokumenty związane z klientem podlegają usunięciu. Decydują o tym cel przetwarzania i właściwa podstawa prawna.[42][100]
Weryfikacja efektu usunięcia we wszystkich systemach
WooCommerce udostępnia ustawienia retencji i obsługi żądań dotyczących danych, powiązane między innymi z narzędziami eksportu i usuwania WordPressa. Dokumentacja WordPressa przewiduje mechanizm, przez który wtyczki dodają własną obsługę usuwania danych. Audyt własnego rozszerzenia musi więc sprawdzić, czy jest ono rzeczywiście zintegrowane z tym procesem. Standardowy przycisk nie obejmuje automatycznie każdej dodatkowej tabeli.[94][99]
Proponowany scenariusz wykorzystuje syntetyczne konto z unikalnym znacznikiem. Znacznik jest widoczny w zamówieniu, wiadomości testowej, eksporcie i uzgodnionych systemach zależnych. Po zatwierdzeniu operacji audytor sprawdza, które dane usunięto, które zanonimizowano, a które zachowano i z jakiego powodu. Brak danych w profilu użytkownika nie przesądza o wyniku w fakturowaniu, magazynie, CRM, systemie wysyłek ani w kopii eksportu pozostawionej na serwerze.
Dla każdej kopii informacji warto wskazać właściciela, cel, termin przechowywania i sposób zakończenia dostępu. To projekt kontroli; okresy retencji każda firma ustala dla siebie. Konkretnych terminów nie należy zgadywać na podstawie popularnej konfiguracji wtyczki ani kopiować z polityki innego sklepu.
Kontrola wcześniejszych decyzji po odtworzeniu kopii zapasowej
Rozważmy hipotetyczny sklep, który prawidłowo usunął konto, a kilka dni później odtworzył bazę sprzed tej operacji. Audyt powinien wykazać, czy przed ponownym uruchomieniem usługi zastosowano aktualne decyzje dotyczące dostępu, usunięcia danych i komunikacji marketingowej. Odtworzenie starego stanu może bowiem przywrócić zamówienia razem z wcześniejszymi ustawieniami, których organizacja nie zamierza już stosować. Scenariusz dotyczy procesu odtwarzania danych, niezależnie od platformy.
Proponowane rozwiązanie organizacyjne to kontrolowany rejestr decyzji, który można uzgodnić z odtworzoną bazą. Rejestr powinien zawierać tylko dane potrzebne do tego celu, a jego dostępność i okres przechowywania wymagają osobnej oceny. Rejestr nie służy do bezterminowego przechowywania pełnej historii klienta pod hasłem „bezpieczeństwa”.
Przed ponowną publikacją środowiska należy potwierdzić, że nie odżyły odwołane konta techniczne, uprawnienia do pobierania dokumentów ani zgody, na których firma nie może już polegać. Zestaw tych decyzji zależy od procesu i podstaw prawnych. Firma potrzebuje spójnego, uzasadnionego modelu przechowywania i odtwarzania. Uniwersalny obowiązek natychmiastowej modyfikacji każdej archiwalnej kopii z tego nie wynika.
Eksport danych jako funkcja podwyższonego ryzyka
W modelu badania eksport podlega tym samym pytaniom co dokument prywatny. Kto go zamawia i kto może go pobrać? Jak długo działa odnośnik, gdzie zostaje plik i co się dzieje po wygaśnięciu uprawnienia? Audytor weryfikuje też adresata powiadomienia. Poprawne utworzenie pliku nie wystarcza, jeśli jego doręczenie lub przechowywanie omija politykę dostępu.
Dla właściciela firmy rezultatem powinien być protokół całego cyklu: utworzenie danych testowych, ich przepływ, realizacja uzgodnionej decyzji, odtworzenie środowiska i ponowna weryfikacja. Kopie zapasowe, prywatność i bezpieczeństwo przestają wtedy być trzema niepowiązanymi dokumentami.
Rozdział 13Odporność tożsamości administracyjnych: MFA, odzyskiwanie i dostęp awaryjny
Najbardziej uprzywilejowane konto bywa poza WordPressem. Może to być konto u rejestratora domeny, konto administratora hostingu, operatora kopii albo osoby publikującej kod. Dlatego proponowany audyt obejmuje cały system tożsamości administracyjnych: logowanie, ustanawianie dodatkowych metod, odzyskiwanie, odwołanie dostępu i powrót do pracy po awarii.
Rodzaje MFA i ich odporność na phishing
NIST SP 800-63B-4 rozróżnia rodzaje uwierzytelniania i ich odporność na phishing. Jako przykład powiązania uwierzytelnienia z nazwą weryfikującego serwisu wskazuje WebAuthn/FIDO2. Hasło i przepisywany kod jednorazowy nie zapewniają tej samej właściwości. To odniesienie techniczne. Samo przywołanie amerykańskich wytycznych nie czyni ich powszechnym obowiązkiem prawnym polskiego sklepu.[89][90]
W proponowanym przeglądzie ustalamy, które kanały są objęte ochroną i czy można dodać alternatywną metodę. Sprawdzamy, kto zatwierdza zmianę i co pozostaje dostępne po utracie podstawowego urządzenia. Takie ustalenia mówią o ochronie więcej niż sam zapis „MFA: tak”. Osobno badamy konto w panelu dostawcy i uwierzytelnienie integracji. Hasła aplikacji w WordPressie są odrębnym mechanizmem dostępu. Test MFA w panelu nie potwierdza więc automatycznie ochrony operacji wykonywanych z ich użyciem.[31][70]
Odzyskiwanie jest oddzielną ścieżką bezpieczeństwa
NIST opisuje odzyskanie konta jako proces odrębny od zwykłego uwierzytelnienia. Obejmuje on odpowiednie metody weryfikacji i powiadamianie użytkownika. W audycie warto więc zaplanować, obok pomyślnego logowania, także utratę składnika, zmianę adresu odzyskiwania i próbę odwołania wcześniejszej metody.[91]
Model badania do uzgodnienia z dostawcą: upoważniony pracownik traci dostęp do jednego składnika, ale nadal może skorzystać z wcześniej ustanowionej metody zapasowej. Zespół sprawdza, czy odzyskanie zostaje zarejestrowane i czy właściwa osoba dostaje informację. Sprawdza też, czy poprzednia metoda rzeczywiście przestaje działać po jej odwołaniu. Działania z udziałem pomocy technicznej wymagają uzgodnienia. Sam audyt strony nie upoważnia do podszywania się pod pracowników dostawcy.
Wynik powinien wskazywać także zależności. Jeżeli wszystkie metody zapasowe leżą w sejfie dostępnym dopiero po zalogowaniu do niedziałającego systemu, plan awaryjny zależy od tej samej awarii. To problem architektury odzyskiwania, nawet gdy każda metoda z osobna jest poprawnie skonfigurowana.
Dostęp awaryjny jako czasowe i kontrolowane uprawnienie
Proponowany model konta awaryjnego obejmuje zdefiniowany cel użycia, ograniczony zakres, ochronę danych dostępowych, alarm po wykorzystaniu i późniejszy przegląd wykonanych operacji. Przy szczególnie istotnych czynnościach może być właściwa dodatkowa akceptacja. Nie powinna ona jednak prowadzić do sytuacji, w której nieobecność jednej osoby blokuje jakąkolwiek reakcję. Sposób działania trzeba sprawdzić przy realnej obsadzie zespołu.
Ćwiczenie kończy się przywróceniem zwykłego modelu pracy. Należy odwołać czasowe uprawnienia, uporządkować utworzone sesje i, zależnie od mechanizmu i ekspozycji, wymienić użyte sekrety. Celem jest zakończenie szczególnego dostępu. Wymiana dotyczy sekretów użytych w ćwiczeniu i nie oznacza arbitralnego nakazu regularnej zmiany wszystkich haseł użytkowników.
Przykładowe kryterium odbioru: wyznaczony zastępca odzyskuje kontrolę nad wskazaną usługą w uzgodnionych warunkach, bez użycia niezatwierdzonego prywatnego konta. Po ćwiczeniu nie zostają dodatkowe aktywne uprawnienia, a zdarzenie ma ślad w rejestrze. Jeśli takiego testu nie przeprowadzono, raport wskazuje to jako ograniczenie i nie zawiera deklaracji „procedura awaryjna działa”.
Rozdział 14Kopia zapasowa ma wartość, gdy da się z niej skorzystać
CISA zaleca utrzymywanie odseparowanych, szyfrowanych kopii danych. Zaleca też regularne sprawdzanie ich dostępności i integralności w scenariuszu odzyskiwania. Ochrona kopii powinna uwzględniać to, że archiwa dostępne dla napastnika mogą zostać usunięte lub zaszyfrowane razem z produkcją. Dodatkowy plik na tym samym koncie serwera nie rozwiązuje tego problemu.[39]
RPO i RTO: dwa różne wymagania biznesowe
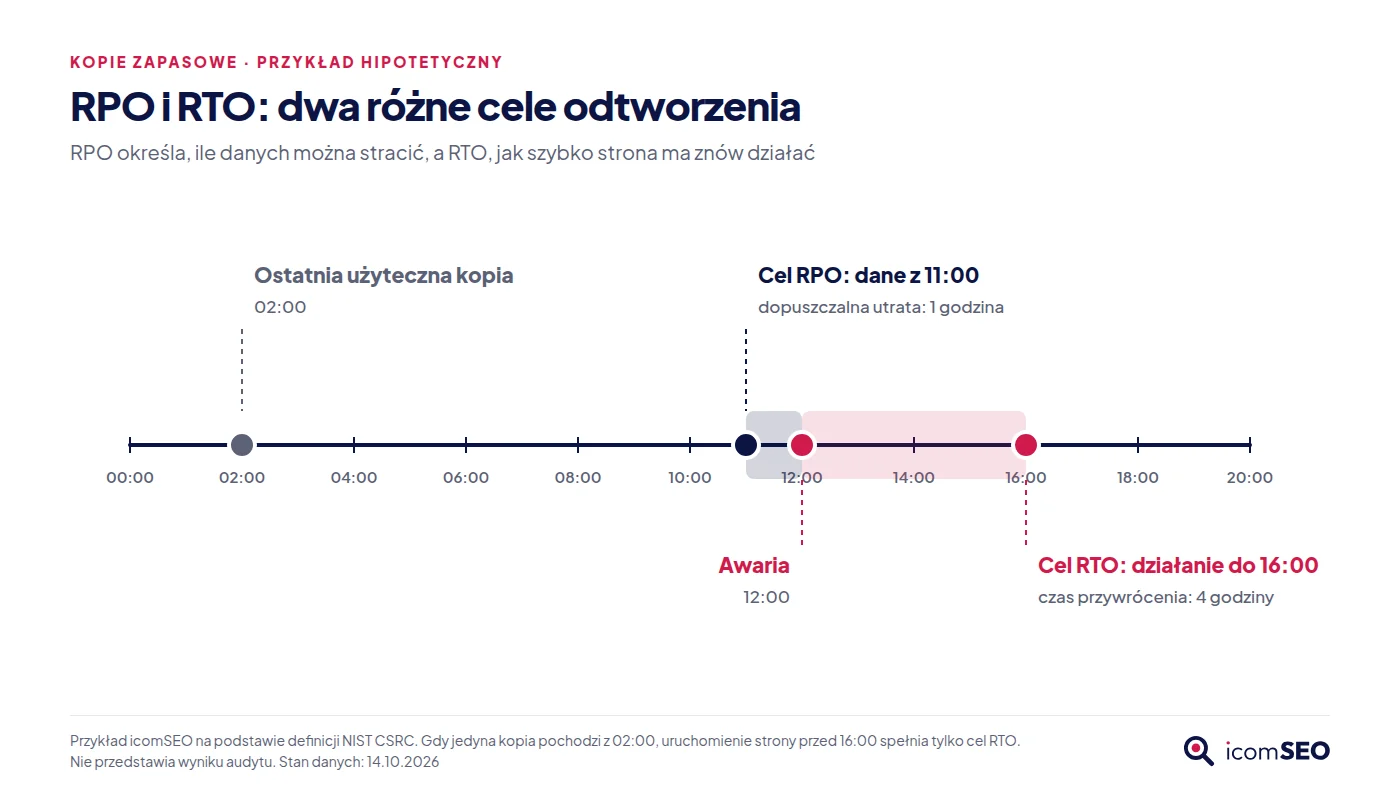
RPO (Recovery Point Objective) określa punkt w czasie, do którego trzeba odzyskać dane. W praktycznym planowaniu wyraża dopuszczalne cofnięcie danych po awarii. RTO (Recovery Time Objective) opisuje docelowy czas przywrócenia działania. Oba parametry to cele, z którymi porównuje się rzeczywiste możliwości. Usługa backupu nie spełnia ich automatycznie.[40][41]
Przykład hipotetyczny: sklep ustala RPO na godzinę i RTO na cztery godziny. Przy awarii o 12:00 oczekuje odtworzenia danych co najmniej do 11:00 i przywrócenia uzgodnionej funkcjonalności do 16:00. Jeżeli jedyna użyteczna kopia pochodzi z 02:00, samo uruchomienie strony przed 16:00 nie spełnia obu celów. Przykład pokazuje różnicę między aktualnością odzyskanych danych a szybkością odtwarzania.
Co powinien wykazać kontrolowany test odtworzenia?
W proponowanym scenariuszu odtwarzanie odbywa się w odizolowanym środowisku. Wysyłka do rzeczywistych klientów i wykonywanie realnych płatności są w nim zablokowane. Zespół sprawdza spójność bazy i plików, logowanie, reprezentatywne zamówienia, załączniki, konfigurację i niezbędne zależności. Ustala też, czy dostępne są klucze potrzebne do odczytu kopii i czy są przechowywane bezpiecznie, oddzielnie i poza zasięgiem nieuprawnionych osób.
Wynikiem powinien być protokół: użyta kopia, odzyskany zakres danych, czas kolejnych etapów, napotkane błędy i osoba zatwierdzająca rezultat. W WooCommerce warto dodatkowo zaplanować uzgodnienie zamówień z operatorem płatności i magazynem. Przywrócenie bazy do wcześniejszego punktu nie cofa operacji wykonanych już przez systemy zewnętrzne.
Trzeba też odróżnić odtworzenie po awarii od powrotu po przejęciu. W drugim przypadku należy ocenić przyczynę naruszenia i wiarygodność źródła odtworzenia. Przywrócenie zawartości bez usunięcia problemu, który umożliwił atak, samo w sobie nie potwierdza bezpieczeństwa.[39]
Scenariusz krytyczny: firma traci panel, pocztę i dostęp do kopii
W proponowanym ćwiczeniu zakładamy, że niedostępna jest zarówno strona, jak i konto administracyjne używane do pobrania backupu. Zespół sprawdza, kto ma alternatywny dostęp, gdzie są klucze odszyfrowania i jak firma odzyska kontrolę nad domeną. To celowo trudniejszy wariant niż przywrócenie kopii przyciskiem w działającym panelu.
Protokół powinien uwzględniać czas odzyskania dostępu, uruchomienia środowiska, weryfikacji danych i wznowienia procesu biznesowego. RTO mierzone dopiero od rozpoczęcia importu bazy pomija wcześniejszą część przerwy. Raport musi więc jawnie określać początek i koniec pomiaru. Powinien też podawać, czy wynik obejmuje pełny uzgodniony scenariusz, czy tylko wycinek techniczny.[41]
W przypadku sklepu osobno opisujemy uzgodnienie zamówień powstałych po punkcie ostatniej kopii. Przed ponowieniem obciążeń, wysyłek czy zwrotów ustala się wiarygodny stan w systemach źródłowych. Dopiero potem wybiera się sposób bezpiecznego uzupełnienia różnic. To proponowane kryterium procesu odtworzenia; szczegóły obsługi zależą od konkretnej bramki płatniczej.
Rozdział 15Przepisy: co ma znaczenie dla strony i jej właściciela?
Zakres obowiązków zależy od roli organizacji, rodzaju danych, sektora i modelu świadczenia usług. Poniższe omówienie ma charakter informacyjny, dotyczy Polski i UE i wymaga dopasowania do konkretnego podmiotu. Audyt witryny może dostarczyć dowodów przydatnych w ocenie zgodności. Pełnej analizy prawnej i organizacyjnej jednak nie zastępuje.
RODO: bezpieczeństwo adekwatne do ryzyka
Art. 32 RODO wymaga odpowiednich środków technicznych i organizacyjnych, uwzględniających ryzyko, kontekst przetwarzania i stan wiedzy technicznej. Wskazuje m.in. zdolność zapewnienia poufności, integralności, dostępności i odporności, przywracania danych oraz regularnego testowania skuteczności zabezpieczeń. Przepis nie ustanawia jednej uniwersalnej częstotliwości pentestu dla wszystkich stron.[42]
W audycie warto powiązać te wymagania z dowodami: testami uprawnień, odtworzeniem kopii, przeglądem aktualizacji i udokumentowaną reakcją na alarm. Znaczenie mają też minimalizacja danych, ochrona danych w fazie projektowania i zasady współpracy z podmiotami przetwarzającymi, wynikające odpowiednio z art. 5, 25 i 28. Raport techniczny to jeden z elementów tej układanki; nazywanie go „certyfikatem RODO” wprowadza w błąd.[42]
Naruszenie danych: termin 72 godzin i przygotowanie reakcji
Zgodnie z wyjaśnieniem UODO administrator zgłasza naruszenie właściwemu organowi bez zbędnej zwłoki, w miarę możliwości w ciągu 72 godzin od jego stwierdzenia. Wyjątkiem jest sytuacja, w której jest mało prawdopodobne, by naruszenie skutkowało ryzykiem naruszenia praw lub wolności osób. Podmiot przetwarzający informuje administratora bez zbędnej zwłoki. Termin nie biegnie automatycznie od każdej technicznej próby ataku.[43]
Zawiadomienie osób, których dane dotyczą, jest odrębnym obowiązkiem. Dotyczy zasadniczo sytuacji wysokiego ryzyka, z uwzględnieniem warunków i wyjątków z art. 34. Osobę, która kwalifikuje zdarzenie i podejmuje decyzję, warto wskazać zawczasu. Decyzja nie musi czekać na kompletny raport informatyczny. Proponowany scenariusz audytowy to ćwiczenie obiegu informacji między wykonawcą, administratorem i osobą odpowiedzialną za ochronę danych.[44]
Cookies i Prawo komunikacji elektronicznej
Art. 399 Prawa komunikacji elektronicznej reguluje przechowywanie informacji i dostęp do informacji w urządzeniu użytkownika. Art. 400 w kwestii zgody odsyła do przepisów o ochronie danych osobowych. Ustawa przewiduje wyjątki m.in. dla czynności koniecznych do transmisji oraz do dostarczenia żądanej usługi. W praktyce ocenia się rzeczywiste działanie mechanizmów. Sama nazwa kategorii „niezbędne” niczego nie przesądza.[45]
W proponowanym badaniu porównuje się żądania sieciowe i zapis informacji przed wyborem użytkownika, po akceptacji, po odmowie i po wycofaniu zgody. Sam baner nie potwierdza prawidłowego działania skryptów. Kontrolę techniczną należy powiązać z oceną celów przetwarzania i treści informacji dla użytkownika. Nie wszystkie naruszenia prywatności są podatnościami aplikacji.[45]
KSC i NIS2: o obowiązkach decyduje status podmiotu
Nowelizacja ustawy o krajowym systemie cyberbezpieczeństwa z 23 stycznia 2026 r., opublikowana w Dz.U. 2026 poz. 252, weszła w życie 3 kwietnia 2026 r. Wprowadziła rozwiązania związane z wdrożeniem NIS2, w tym podział na podmioty kluczowe i podmioty ważne. Samo korzystanie z WordPressa lub prowadzenie sklepu nie przesądza o kwalifikacji organizacji.[46][47]
Ministerstwo Cyfryzacji wskazuje harmonogram dla podmiotów, które spełniały przesłanki już w dniu wejścia nowelizacji w życie. Termin samorejestracji dla organizacji zobowiązanych do niej upłynął 3 października 2026 r. Wdrożenie obowiązków przypada do 3 kwietnia 2027 r. Pierwszy obowiązkowy audyt nowych podmiotów kluczowych wskazanych w przepisach przejściowych przypada do 3 kwietnia 2028 r. Ministerstwo odróżnia przy tym podmioty, które wcześniej były operatorami usług kluczowych. Terminy dotyczą wyłącznie wskazanych grup. Tryb wpisu i przepisy przejściowe trzeba sprawdzić indywidualnie.[48][49][72]
Audyt strony i ustawowy audyt KSC to odrębne usługi. Przeglądu jednej aplikacji nie należy utożsamiać z oceną organizacji i systemów objętych ustawą. Najpierw potrzebna jest kwalifikacja podmiotu i zakresu obowiązków. Następnie trzeba odpowiednio zdefiniować usługę i wymagania wobec wykonawcy.[46]
CRA: ważne rozróżnienie dla dostawców wtyczek i motywów
Cyber Resilience Act dotyczy produktów z elementami cyfrowymi i obowiązków określonych uczestników rynku. Główne obowiązki mają zastosowanie od 11 grudnia 2027 r. Określone obowiązki zgłaszania przez producentów obowiązują od 11 września 2026 r. Rozporządzenie nie nakłada identycznych obowiązków na każdego administratora strony ani każdego współtwórcę projektu open source.[50][63]
W ekosystemie WordPressa warto odróżnić użytkownika wtyczki od podmiotu, który rozwija i udostępnia produkt w ramach działalności komercyjnej. Komisja Europejska opisuje szczególne podejście do oprogramowania otwartego i odrębną kategorię open-source stewards. Praktyczny wniosek dla właściciela strony to pytanie dostawcy o utrzymanie produktu, obsługę zgłoszeń podatności i politykę poprawek. Obowiązków producenta właściciel strony nie powinien automatycznie przypisywać sobie.[51][63]
Incydent bezpieczeństwa, naruszenie danych i podatność to różne zdarzenia
Nieudana próba logowania, odkryta luka i potwierdzony nieuprawniony dostęp to różne pojęcia. EDPB wskazuje, że naruszenie ochrony danych może polegać na ujawnieniu informacji, utracie ich dostępności lub ich zniszczeniu. Jednocześnie nie każdy incydent techniczny jest naruszeniem danych osobowych.[71]
W audycie warto przećwiczyć rozdzielenie czterech pytań: co faktycznie zaszło, jakie dane objęło zdarzenie, jakie ryzyko dotyczy osób i kto decyduje o zgłoszeniu. Podatność w funkcji pobierania dokumentów nie dowodzi wcześniejszego masowego wycieku. Z drugiej strony brak pełnych logów nie dowodzi, że nikt z niej nie skorzystał. W takiej sytuacji raport opisuje ograniczenia ustalenia. Arbitralny wybór korzystniejszej wersji byłby błędem.
Administrator powinien dokumentować naruszenia również wtedy, gdy nie ma obowiązku zgłoszenia ich organowi. Jeżeli obowiązek zgłoszenia istnieje, nie trzeba czekać, aż wszystkie informacje będą dostępne jednocześnie. EDPB opisuje ich uzupełnianie etapami. Obieg danych między hostingiem, agencją i administratorem trzeba przygotować wcześniej.[71]
Jak przełożyć przepisy na zakres audytu bez pozornej certyfikacji
Poniższa mapa służy do planowania. Nie jest opinią prawną ani pełną listą obowiązków. Wskazuje, jakie pytania powinny trafić do audytu technicznego i co wymaga odrębnej decyzji organizacyjnej.
| Obszar | Przydatny dowód techniczny lub organizacyjny | Czego sam audyt strony nie rozstrzyga |
|---|---|---|
| RODO, art. 32 | Próby uprawnień, test odtworzenia, wyniki kontroli zabezpieczeń. | Pełnej zgodności wszystkich procesów przetwarzania danych. |
| RODO, art. 33–34 | Oś czasu zdarzenia, sposób eskalacji, dostępność danych do oceny ryzyka. | Automatycznego obowiązku zgłoszenia każdej znalezionej luki. |
| PKE, art. 399–400 | Zachowanie skryptów i zapisu informacji w różnych stanach zgody. | Prawidłowości wszystkich celów i podstaw przetwarzania. |
| KSC / NIS2 | Wyniki kontroli aplikacji jako część szerszej oceny systemów. | Statusu podmiotu i spełnienia całego ustawowego zakresu audytu. |
| CRA | Inwentaryzacja produktów, kontakty do dostawców, proces obsługi podatności. | Tego, że każdy właściciel strony jest producentem produktu cyfrowego. |
| PCI DSS | Architektura integracji płatniczej i kontrola skryptów checkoutu. | Doboru właściwego SAQ i formalnego potwierdzenia zgodności. |
Podstawy zakresów: RODO i wyjaśnienia EDPB, PKE, przepisy i komunikaty dotyczące KSC, materiały Komisji Europejskiej oraz PCI SSC. Mapowanie dowodów jest propozycją autorów.[42][45][46][50][64][71]
Rozdział 16Bezpieczeństwo, SEO i zaufanie: rzeczywisty związek bez obietnic rankingowych
Google informuje, że strony z problemami bezpieczeństwa mogą otrzymywać ostrzeżenia w wynikach wyszukiwania lub w przeglądarce. Treści wstawione przez atakujących, złośliwe przekierowania i złośliwe oprogramowanie mogą wymagać naprawy w całej witrynie, a potem zgłoszenia jej do ponownego sprawdzenia. Wyczyszczenie kilku widocznych adresów nie musi rozwiązać całego problemu.[52]
W audycie warto uwzględnić integralność treści, nieautoryzowane zmiany przekierowań i dostęp do narzędzi zarządzania widocznością. Dla właściciela firmy stawką jest ruch oraz to, czy użytkownik trafia na prawidłową ofertę i bezpieczny proces kontaktu. To biznesowe uzasadnienie rozszerzenia zakresu o te elementy. Gwarancji wzrostu konwersji z tego nie wynika.
Audyt bezpieczeństwa i pozycjonowanie w Google to odrębne usługi. HTTPS i dobre doświadczenie użytkownika są istotne. Samo wdrożenie certyfikatu czy usunięcie alertu nie uzasadnia jednak obietnicy lepszych pozycji. Google opisuje ocenę doświadczenia strony jako szeroki zestaw właściwości, w którym bezpieczeństwo jest jednym z elementów.[53]
W komunikacji z klientem proponujemy więc mówić o ochronie wiarygodności i ograniczaniu ryzyka zakłócenia ruchu. Obietnica „bonusu SEO za audyt” nie ma podstaw. Profesjonalna oferta oddziela potwierdzone konsekwencje incydentu od nieudowodnionych procentów wzrostu sprzedaży.
Indeksowanie i kontrola dostępu to osobne mechanizmy
Oznaczenie zasobu jako noindex dotyczy wyłącznie obecności w wynikach wyszukiwania. Nie ogranicza prawa do odczytania zasobu. Google zwraca też uwagę, że robot musi móc pobrać stronę, aby rozpoznać dyrektywę noindex. Równoczesna blokada w robots.txt może uniemożliwić jej odczyt. Dokumentów klientów i kopii zapasowych nie należy chronić wyłącznie ustawieniem indeksowania.[74]
W proponowanym audycie rozdzielamy dwa testy. Pierwszy sprawdza, czy treści publiczne mają prawidłowe zasady indeksowania, a drugi, czy prywatne zasoby wymagają właściwej autoryzacji. Po incydencie należy też przejrzeć konta w narzędziach dla webmasterów i znane sposoby potwierdzenia własności. Usunięcie spamu bez usunięcia drogi ponownej publikacji nie zamyka problemu.
Rozdział 17Ocena ryzyka: co poza wynikiem CVSS decyduje o kolejności napraw
CVSS opisuje dotkliwość podatności i pozwala uwzględnić m.in. charakterystykę zagrożenia oraz środowiska. Sama wartość bazowa nie jest jednak pełną oceną ryzyka firmy. Ta sama słabość może mieć inne konsekwencje w odizolowanej funkcji testowej i w publicznym procesie obsługującym dane klientów. Raport powinien więc pokazać obok liczby przesłanki oceny.[54]
EPSS szacuje prawdopodobieństwo, że opublikowana podatność CVE zostanie wykorzystana w rzeczywistych atakach w ciągu kolejnych 30 dni. Nie prognozuje włamania do konkretnej instalacji. Katalog KEV CISA dokumentuje podatności ze stwierdzonym wykorzystaniem. Brak wpisu nie dowodzi, że dana luka nie zostanie użyta. Oba źródła dostarczają sygnałów wspierających decyzję, a analiza własnego środowiska pozostaje osobnym zadaniem.[55][56]
W proponowanym modelu priorytet wynika z odpowiedzi na pięć pytań: czy problem dotyczy naszego komponentu, kto może do niego dotrzeć, jakie uprawnienia są potrzebne, jaki skutek wykazano i jakie zabezpieczenia ograniczają szkodę. Ocenia się też dostępność poprawki oraz ryzyko samego wdrożenia. Ostateczna decyzja o akceptacji ryzyka powinna mieć właściciela biznesowego.
| Priorytet (model przykładowy) | Charakter sytuacji | Proponowany sposób działania |
|---|---|---|
| P1: krytyczny | Aktywne przejęcie albo wiarygodny scenariusz poważnej szkody w dostępnej funkcji. | Natychmiastowa eskalacja i ograniczenie ekspozycji; naprawa w trybie pilnym. |
| P2: wysoki | Potwierdzony istotny problem bez oznak trwającego incydentu. | Szybka decyzja właściciela i najbliższe bezpieczne wdrożenie z retestem. |
| P3: średni | Istotna słabość przy dodatkowych warunkach lub ograniczonym skutku. | Zaplanowana poprawka z terminem, odpowiedzialnością i dowodem weryfikacji. |
| P4: niski | Ograniczony wpływ lub usprawnienie ochrony bez wykazanego poważnego scenariusza. | Włączenie do planu utrzymania albo udokumentowana akceptacja ryzyka. |
Tabela przedstawia propozycję modelu zarządzania. Nie jest skalą ustawową ani gotowym SLA. Czas reakcji, czas ograniczenia ryzyka i termin trwałej naprawy uzgadnia się osobno.
„Niskie ryzyko” nie oznacza braku potrzeby działania. Drobne braki mogą ujawniać problem procesu: brak właściciela komponentu, nieskuteczne aktualizacje albo nieodbierane alarmy. Wiele alertów wynikających z jednej przyczyny nie powinno z kolei sztucznie zwiększać liczby niezależnych zagrożeń w podsumowaniu.
Trzy niezależne wyniki: dotkliwość, pewność ustalenia i pilność działania
W proponowanym raporcie oddzielamy poziom szkody od jakości dowodu. Potwierdzony brak nagłówka o ograniczonym znaczeniu nie powinien wyprzedzać uzasadnionego podejrzenia aktywnego przejęcia tylko dlatego, że łatwiej go udokumentować. Podejrzenie zachowuje swój status i otrzymuje pilną czynność wyjaśniającą. Taki zapis ułatwia działanie i nie wyolbrzymia faktów.
Czwartym wymiarem jest ryzyko pozostałe po zastosowaniu zabezpieczeń. Wyłączenie podatnej funkcji, ograniczenie dostępu i naprawa kodu mają różne skutki i różną trwałość. Właściciel powinien wiedzieć, czy przywrócenie funkcji odtworzy problem i kto ma ponownie ocenić sytuację. Użyteczna decyzja zarządcza o „akceptacji ryzyka” określa zakres, właściciela i datę przeglądu.
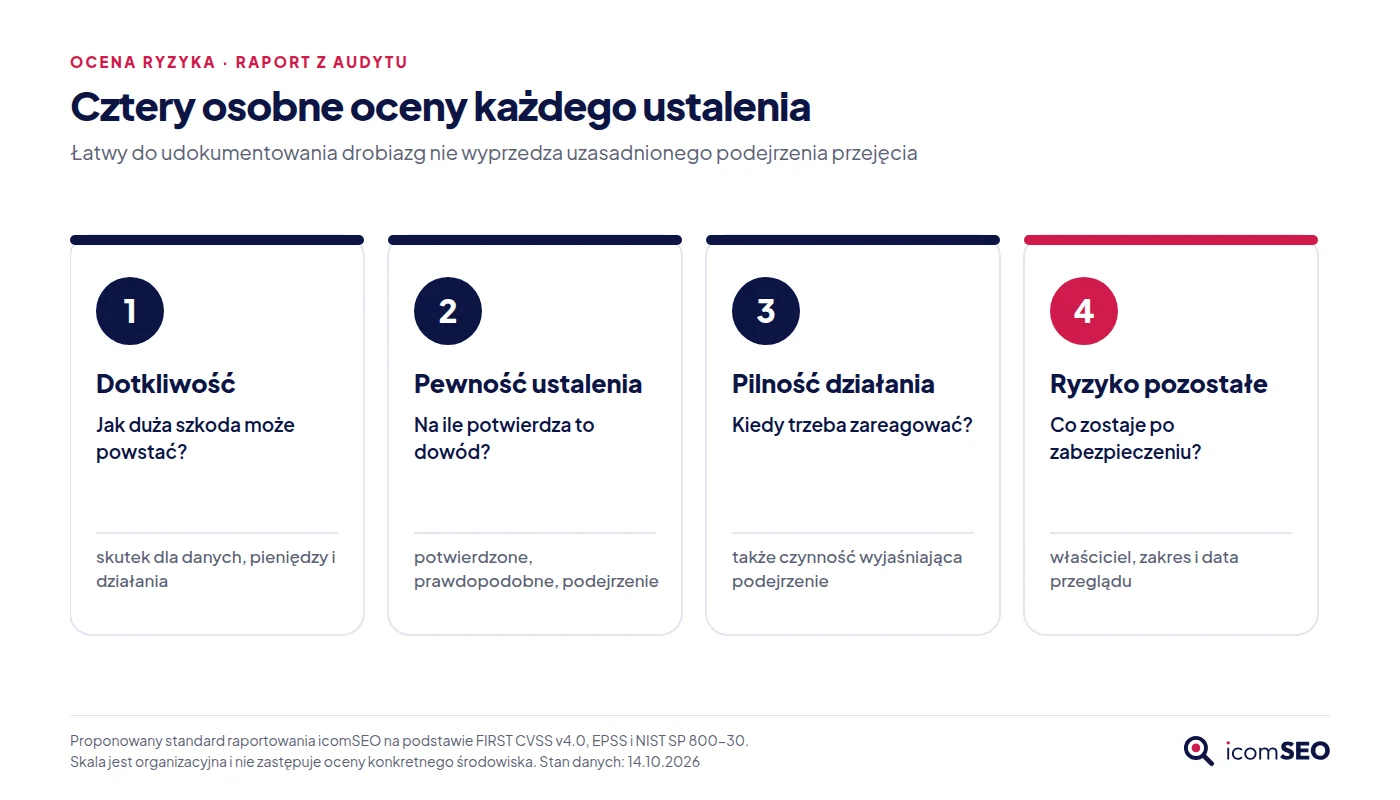
Uzasadnienie kosztu bez fikcyjnego „zwrotu z audytu”
Priorytet techniczny i uzasadnienie wydatku odpowiadają na różne pytania. Ocena ryzyka wskazuje, jakiej szkody dotyczy problem i jak pewny jest dowód. Analiza ekonomiczna wymaga ponadto własnych danych o marży, czasie niedostępności i kosztach reakcji. Wynik CVSS ani liczba ujawnionych luk w ekosystemie tych danych nie zastąpią.
Rozdział 18 pokazuje trzy jawnie hipotetyczne warianty kosztu przerwy oraz analizę wrażliwości. Model oddziela utraconą marżę od kosztów dodatkowych. Nie przypisuje prawdopodobieństw bez danych i nie ogłasza kwoty, którą audyt na pewno zaoszczędzi.
Rozdział 18Ekonomika ryzyka: analiza wrażliwości i granice obietnic ROI
Ocena kosztu ma wspierać decyzję bez tworzenia pozoru precyzji. NIST IR 8286D opisuje wykorzystanie analizy wpływu na biznes do priorytetyzacji ryzyka, także w odniesieniu do poufności i integralności. NIST SP 800-30 rozróżnia elementy oceny ryzyka i wskazuje potrzebę uwzględnienia niepewności. Poniższe obliczenia są własnym, uproszczonym modelem dydaktycznym. Żadna z tych publikacji nie wymaga takiej metody wyceny.[95][96]
Najpierw nazwij konkretną stratę
Przy przerwie w sprzedaży warto oddzielić transakcje utracone od odłożonych, przychód od marży oraz dodatkowy wydatek od kosztu już ponoszonego. Przy nieprawidłowych zwrotach liczy się rzeczywista wartość operacji i możliwość odzyskania środków. Ujawnienie danych wymaga innej analizy, bo samo odtworzenie serwera nie cofa naruszenia poufności. Nie należy sumować wszystkich możliwych scenariuszy tak, jakby każdy miał wystąpić podczas jednego incydentu.
Dla hipotetycznej przerwy w sklepie przyjmijmy model:
Koszt scenariusza = trwale utracona marża + dodatkowy koszt reakcji + dodatkowy koszt usług zewnętrznych + koszt uzgodnienia operacji.
W przykładzie trwale utracona marża to: liczba potencjalnych zamówień na godzinę × czas przerwy × marża na zamówieniu × udział zakupów, których klienci później nie zrealizują. Każdy parametr wymaga danych i uzgodnienia. W rzeczywistym zastosowaniu trzeba też sprawdzić sezonowość oraz to, czy przyjęta marża obejmuje koszty, których firma nie poniesie.
Trzy warianty tej samej sytuacji
Wszystkie poniższe liczby są fikcyjne. Zakładamy 80 potencjalnych zamówień na godzinę i 100 zł marży na zamówieniu. Warianty różnią się czasem przerwy, udziałem trwale utraconych zakupów i kosztem obsługi. Nie przypisujemy im prawdopodobieństw. Żaden wynik nie jest prognozą straty konkretnego sklepu.
| Wariant hipotetyczny | Jawne założenia | Obliczony koszt |
|---|---|---|
| A: przerwa 2 godziny | 15% zakupów utraconych; reakcja 8 h × 250 zł; usługi 5 000 zł; uzgodnienie 40 operacji × 20 zł. | 2 400 + 2 000 + 5 000 + 800 = 10 200 zł. |
| B: przerwa 6 godzin | 40% zakupów utraconych; reakcja 24 h × 250 zł; usługi 12 000 zł; uzgodnienie 120 operacji × 20 zł. | 19 200 + 6 000 + 12 000 + 2 400 = 39 600 zł. |
| C: przerwa 12 godzin | 70% zakupów utraconych; reakcja 48 h × 250 zł; usługi 18 000 zł; uzgodnienie 240 operacji × 20 zł. | 67 200 + 12 000 + 18 000 + 4 800 = 102 000 zł. |
Godziny reakcji to łączny nakład pracy kilku osób i nie wydłużają czasu niedostępności. Koszt uzgodnienia dotyczy wydzielonej pracy, której nie ujęto w reakcji. W innym modelu te pozycje mogłyby się pokrywać i wtedy ich dodanie zawyżałoby wynik. Tabela nie obejmuje wszystkich możliwych skutków. Jej trzech kwot nie należy sumować ani traktować jako przedziału ufności.
Zmieniaj jeden parametr, aby zrozumieć wrażliwość
W wariancie B zmiana założenia o trwale utraconych zakupach z 40% na 20%, przy pozostałych parametrach bez zmian, zmniejsza koszt utraconej marży z 19 200 zł do 9 600 zł. Cały koszt wynosi wtedy 30 000 zł. Wiedza o zachowaniu klientów może więc istotnie zmienić wynik, choć liczba podatności w skanerze pozostaje taka sama.
Przy niezmienionym udziale 40% każda dodatkowa godzina przerwy oznacza w tym modelu 3 200 zł zagrożonej marży. Nie wynika z tego, że pozostałe koszty rosną liniowo. Osobna analiza parametrów ułatwia decyzję, co dopracować najpierw: odtworzenie, monitorowanie, odporność procesu zamówień czy kontrolę uprzywilejowanego dostępu.
Porównuj opcje i jawnie opisuj niepewność
Koszt audytu nie jest automatycznie równy unikniętej stracie. Audyt dostarcza wiedzy. Ograniczenie ryzyka wymaga zwykle wdrożenia i utrzymania zmian. Porównanie wariantów powinno więc uwzględniać koszt diagnozy, napraw, przestojów wdrożeniowych, licencji, obsługi i późniejszego potwierdzania kontroli. Nie należy zakładać stuprocentowej skuteczności ochrony.
Bez wiarygodnych danych o częstości scenariusza i skuteczności konkretnej zmiany nie ma podstaw do ogłaszania rocznej oszczędności ani procentowego ROI. Użyteczniejsza bywa decyzja warunkowa: „najpierw wykonujemy test odtworzenia, ponieważ jego wynik rozstrzygnie, czy deklarowany czas odzyskania usługi jest realny”. Wartością dodatkowego badania jest wtedy usunięcie istotnej niewiedzy.
Rozdział 19Jak powinien wyglądać raport, z którego da się korzystać?
OWASP WSTG zaleca raportowanie zrozumiałe dla odbiorcy biznesowego i technicznego. Poza podsumowaniem istotne są zakres, metoda, ustalenia, wpływ i rekomendacje. Dowody powinny umożliwiać weryfikację problemu bez niepotrzebnego powielania informacji wrażliwych.[57]
W proponowanym standardzie każde ustalenie otrzymuje identyfikator, status pewności, zasób, opis skutku, warunki wystąpienia i właściciela naprawy. Zapisuje się też sposób ograniczenia ryzyka, docelowe rozwiązanie i kryterium retestu. Statusy „potwierdzone”, „podejrzenie”, „nie dotyczy” i „nie zbadano” trzeba rozróżniać, bo prowadzą do innych decyzji.
Przykład: dostęp do dokumentu innego klienta
Poniższa karta jest fikcyjnym przykładem sposobu raportowania. Nie opisuje podatności wykrytej na stronie użytkownika ani rzeczywistego problemu konkretnej wtyczki.
| Pole ustalenia | Przykładowa zawartość |
|---|---|
| Identyfikator i zasób | AUD-01; funkcja pobierania dokumentów w panelu klienta. |
| Warunki | Dwa konta testowe i dwa dokumenty przypisane do różnych właścicieli. |
| Obserwacja | Konto A otrzymuje dokument konta B mimo braku uprawnienia do tego zasobu. |
| Dowód | Zanonimizowany zapis żądania i odpowiedzi, czas testu oraz mapowanie obiektu do właściciela. |
| Potencjalny skutek | Nieuprawniony odczyt danych objętych zakresem dokumentu; skala wymaga osobnego ustalenia. |
| Rekomendacja | Kontrola uprawnień do konkretnego dokumentu po stronie serwera we wszystkich ścieżkach dostępu. |
| Kryterium retestu | Konto A nie odczytuje dokumentu B; konto B zachowuje prawidłowy dostęp; sprawdzone są także alternatywne ścieżki. |
Profesjonalizm polega w tym przykładzie na rozdzieleniu obserwacji od wniosków, bez dopisywania dramatycznego opisu szkody. Odczyt dwóch dokumentów testowych nie uprawnia do stwierdzenia, że „wyciekła cała baza”. Taki wniosek wymaga odrębnych dowodów. Samo występowanie podatności nie przesądza też, że ktoś ją wcześniej wykorzystał.
Retest sprawdza efekt naprawy
Proponowane kryterium zamknięcia ustalenia obejmuje trzy elementy: potwierdzenie właściwej wersji w środowisku docelowym, brak możliwości odtworzenia błędu w warunkach objętych testem oraz prawidłowe działanie niezbędnych funkcji. Zmiana kodu w repozytorium nie jest jeszcze wdrożeniem produkcyjnym. Wyłączenie alertu również nie usuwa problemu.
Warto rozdzielić statusy: „naprawiono”, „ograniczono ryzyko”, „zaakceptowano ryzyko” i „nie można zweryfikować”. Zabezpieczenie zastępcze może być uzasadnione, jeśli ma określony zakres i termin ponownej decyzji. Przy ustaleniach nadal otwartych raport końcowy wskazuje, co pozostaje do zrobienia.
Rozdział 20Od wymagania do dowodu: jak odbierać jakość audytu
Długi raport może nie odpowiadać na najważniejsze pytanie: skąd wiadomo, że zabezpieczenie działa? Proponujemy wymagać krótkiej ścieżki weryfikacji dla każdej istotnej kontroli: wymaganie, zasób, metoda, wynik, dowód, ograniczenie i decyzja. Zrzut ekranu z ustawieniem opisuje konfigurację. Test pokazuje zachowanie w zbadanych warunkach. Historia wykonania pokazuje działanie w czasie. Te dowody uzupełniają się i żaden z nich nie zastępuje pozostałych.
Przykładowe powiązanie z konkretnymi wymaganiami ASVS 5.0.0
Tabela używa identyfikatorów z oznaczonego wydania ASVS 5.0.0. Opisy są skróconymi parafrazami, a scenariusze i kryteria odbioru to autorski przykład zastosowania. Tabela nie jest pełną macierzą zgodności ani potwierdzeniem spełnienia poziomu ASVS.[75][76][77][78]
| Wymaganie | Przykładowa kontrola w stronie lub sklepie | Dowód potrzebny do oceny |
|---|---|---|
| ASVS v5.0.0-8.2.2 | Konto klienta nie odczytuje dokumentu przypisanego innemu klientowi. | Próba dozwolona dla właściciela i odmowa dla drugiego konta testowego. |
| ASVS v5.0.0-8.2.3 | Użytkownik nie zmienia pola, do którego nie ma uprawnienia. | Polityka pól i wynik testu zapisu po stronie serwera. |
| ASVS v5.0.0-7.4.1 | Sesja nie działa po jej zakończeniu. | Kontrolowana próba ponownego użycia zakończonej sesji. |
| ASVS v5.0.0-5.3.1 | Przesłany plik w publicznej lokalizacji nie wykonuje się jako kod serwera. | Konfiguracja przechowywania i bezpieczny test w uzgodnionym środowisku. |
| ASVS v5.0.0-16.2.1 | Zdarzenie zawiera dane potrzebne do odtworzenia przebiegu operacji. | Przykładowy wpis z czasem, źródłem, podmiotem i działaniem. |
Istotne rozróżnienie zakresu: wymagania aplikacyjne dotyczące logowania zdarzeń nie potwierdzają jeszcze działania całego systemu alarmowania. ASVS oddziela te obszary. Test dostarczenia alarmu, obsługi dyżuru i eskalacji trzeba zamówić i ocenić osobno.[78]
Status kontroli pokazuje także brak wiedzy
W proponowanym modelu stosujemy pięć statusów: „spełniono w zbadanym zakresie”, „niespełniono”, „częściowo spełniono”, „nie zweryfikowano” i „nie dotyczy”. Dwa ostatnie wymagają uzasadnienia i nie powinny zwiększać wskaźnika zgodności. Status „nie dotyczy” musi wynikać z architektury lub funkcji serwisu. Brak czasu na test go nie uzasadnia.
Przykładowo MFA może działać przy logowaniu administratora do WordPressa i pozostać niesprawdzone dla panelu hostingu. Poprawny raport podaje oba wyniki oddzielnie. Uśredniona ocena „dostępy bezpieczne” zaciera istotną granicę. Podsumowanie zarządcze pokazuje osobno pokrycie badania, wykryte braki i ryzyka pozostające bez rozstrzygnięcia.
Minimalny standard materiału dowodowego
Dla powtarzalności warto zapisać datę i strefę czasową, środowisko, wersję aplikacji, rolę testową, identyfikator scenariusza i oczekiwany rezultat. Dowód powinien zawierać tylko informacje potrzebne do potwierdzenia wniosku. Materiały z danymi klientów, sesjami i sekretami wymagają ograniczenia dostępu i retencji. Raport do szerszego obiegu powinien być wersją zredagowaną, bez pełnego archiwum ruchu.
Proponujemy powiązać ustalenie z zadaniem naprawczym i identyfikatorem retestu. Klient przechodzi wtedy od wniosku biznesowego do potwierdzenia wdrożenia bez odgadywania, którego pliku lub wersji dotyczyła poprawka. Podstawą odbioru usługi jest wykonanie uzgodnionego zakresu i rzetelność udokumentowanych wyników, niezależnie od liczby znalezionych błędów.
Trzy warstwy oceny zabezpieczenia
Warto oddzielić projekt kontroli, jej rzeczywiste wdrożenie i działanie w badanym okresie. Procedura może trafnie opisywać kopie, które na produkcji wcale się nie wykonują. Jednorazowy test może się udać, choć zadanie cykliczne później przestało się uruchamiać. Dowody nie są wtedy sprzeczne: odpowiadają na inne pytania i dotyczą innych chwil.
NIST SP 800-53A wyróżnia analizę materiałów, rozmowę z odpowiedzialnymi osobami i testowanie zachowania. Metody dobiera się do celu i wymaganej głębokości oceny. W tym artykule służą jako odniesienie metodyczne i nie oznaczają deklaracji wykonania pełnej oceny według NIST.[80]
Przykładowo przy alarmowaniu należy obejrzeć regułę, omówić dyżur i wywołać bezpieczne zdarzenie testowe. Dopiero zestaw tych obserwacji pozwala oddzielić stan „reguła istnieje” od stanu „informacja dotarła do właściwej osoby i została obsłużona”. Profesjonalny raport opisuje każdą rozbieżność i przedstawia wszystkie zebrane dowody, także te mniej korzystne.
Rozdział 21Katalog scenariuszy: od polityki dostępu do wyniku testu
Profesjonalny scenariusz zaczyna się od reguły biznesowej, która ma pozostać prawdziwa: klient widzi własne dokumenty, jedno potwierdzenie płatności wywołuje jedną realizację, a odtworzony sklep nie wysyła ponownie opłaconych zamówień. Dopiero potem dobiera się narzędzia, dane, konta, kanały i sposób obserwowania wyniku.
Poniższe trzy karty to modele redakcyjne do uzgodnienia przed testami. Nie są uniwersalną instrukcją do uruchomienia na dowolnej stronie i nie opisują wykrytych luk. Próby wykonuje się na własnych zasobach testowych, za zgodą uprawnionego właściciela. Zachowanie operatora płatności symuluje się lub sprawdza w dopuszczonym przez niego środowisku. Każda karta obejmuje próbę pozytywną, w której dozwolona operacja działa, oraz negatywną, w której niedozwolona operacja nie osiąga skutku.
SCN-01. Izolacja dokumentów klientów w WordPressie
Reguła i przygotowanie. Przyjmijmy portal B2B z firmami A i B. Każda ma konto klienta oraz jeden dokument zawierający wyłącznie dane syntetyczne. Osobne konto pracownika ma dostęp tylko do przydzielonych spraw. Właściciel procesu zatwierdza, kto może dokument odczytać, pobrać i przekazać dalej. Odrębnie rozstrzyga zasady dostępu przez link. To, czy publiczny odnośnik jest zamierzony, ustala się przed testem.
Badanie. Audytor potwierdza dostęp właściciela, a następnie sprawdza odmowę dla drugiej firmy, pracownika bez przydziału i niezalogowanego odbiorcy. Zakres obejmuje każdą uzgodnioną drogę do dokumentu: panel, REST API, eksport i bezpośredni adres pliku. Jeśli link ma działać bez sesji, sam model jest dopuszczalny, a test obejmuje zatwierdzone warunki ważności i odwołania linku. Ten sam plik trzeba obserwować także przez używaną warstwę cache.
Dowód. Zapis obejmuje identyfikator dokumentu testowego, relację właściciela, rolę, kanał, wynik i zredagowany fragment odpowiedzi. O wyniku decyduje faktyczne udostępnienie treści, więc sam kod HTTP nie wystarcza do oceny. Do wykazania błędu na uzgodnionej próbie nie trzeba masowo pobierać dokumentów rzeczywistych klientów.
Kryterium odbioru. Każda zabroniona relacja z zatwierdzonej macierzy kończy się brakiem dostępu do treści, a dozwolona funkcja pozostaje użyteczna. Test przerwany lub ścieżka niedostępna otrzymują osobny status. Retest powtarza także drogę bezpośrednią i sprawdza, czy w cache nie pozostała historyczna kopia odpowiedzi.
| Relacja w modelu SCN-01 | Odczyt w panelu | Pobranie przez API lub eksport |
|---|---|---|
| Klient A → własny dokument A | Dozwolony. | Dozwolony w zatwierdzonych kanałach. |
| Klient A → dokument firmy B | Zabroniony. | Zabroniony. |
| Pracownik → dokument poza przydziałem | Zabroniony. | Zabroniony. |
| Konto bez aktywnej sesji → dokument prywatny | Zabroniony. | Zabroniony, poza osobno zatwierdzonym modelem linku. |
Macierz ilustruje politykę dostępu przyjętą w konkretnym portalu, niezależną od domyślnych ról WordPressa. Metodyczne uzasadnienie sprawdzania relacji uprawnień i automatyzacji takich prób podaje OWASP Authorization Testing Automation.[81]
SCN-02. Płatność i pojedyncza realizacja w WooCommerce
Reguła i przygotowanie. W tym modelu zamówienie trafia do realizacji dopiero po wiarygodnym potwierdzeniu właściwej transakcji. Potrzebne są: testowy produkt, dedykowane zamówienie, konto klienta, środowisko operatora przeznaczone do integracji oraz zablokowana rzeczywista wysyłka. Warto z góry odróżnić ponowne przetworzenie komunikatu od ponownego zaksięgowania lub wydania towaru.
Badanie. Zespół sprawdza poprawną płatność, powrót użytkownika z przerwanego procesu, ponowne dostarczenie tego samego potwierdzenia, potwierdzenie dotyczące innego zamówienia oraz uzgodniony przypadek komunikatów w zmienionej kolejności. Sprawdzeniu podlega cały obserwowalny skutek: status, zapis rozliczenia, wiadomość, przydzielenie produktu cyfrowego i zadanie wysyłkowe. Próby nie wymagają manipulowania prawdziwymi rozliczeniami klientów.
Dowód. Raport wiąże identyfikatory testowego zamówienia, transakcji i zdarzenia integracyjnego. Potrzebna jest oś czasu oraz stan przed operacją i po niej. Zapis „webhook zwrócił sukces” nie dowodzi, że sklep prawidłowo sprawdził treść komunikatu ani że integracja magazynowa nie utworzyła duplikatu.
Kryterium odbioru. Poprawna płatność prowadzi do zamierzonego skutku, a duplikat nie tworzy drugiego skutku finansowego lub logistycznego. Niepoprawne potwierdzenie nie nadaje uprawnień do produktu. Zdarzenia wymagające wyjaśnienia widzi osoba obsługująca rozliczenia. Retest obejmuje również legalne ponowienie po chwilowej awarii, bo naprawa nie może polegać na blokowaniu wszystkich powtórzeń.
Karta stosuje zasady autoryzacji transakcji i integracji z bramką płatności do hipotetycznego sklepu. Szczegółowe reguły podpisu, statusów i ponowień trzeba zaczerpnąć z dokumentacji rzeczywiście używanego operatora. Bramki różnią się kontraktem webhooka.[35][36]
SCN-03. Odtworzenie sklepu bez powielania operacji
Reguła i przygotowanie. Celem jest przywrócenie uzgodnionej usługi ze spójnymi danymi. Sama działająca strona główna nie spełnia tego warunku. Przed ćwiczeniem zapisuje się punkt kopii, zakres danych, dopuszczalną utratę informacji i warunek uznania usługi za gotową. Odizolowane środowisko powinno mieć kontrolowane połączenia wychodzące, aby nie wysłać prawdziwych wiadomości, zwrotów ani zleceń do magazynu.
Badanie. Osoba wskazana w procedurze odzyskuje dostępy, odtwarza bazę i pliki, przywraca konfigurację, a następnie sprawdza klienta, zamówienie, dokument i zadania w tle. W osobnym kroku uzgadnia się operacje powstałe po punkcie kopii z dostępnymi danymi operatora płatności i magazynu. Wszystkie działania pozostają w granicach uzgodnionych uprawnień i zasad ochrony danych.
Dowód. Protokół pokazuje pełną oś czasu od uruchomienia procedury do potwierdzenia gotowości, łącznie z czasem kopiowania. Rejestr rozbieżności zawiera kategorię problemu, właściciela wyjaśnienia i decyzję. Odnotowuje się również sytuację, w której odtworzenie udało się wyłącznie dzięki pomocy osoby nieprzewidzianej w normalnej procedurze.
Kryterium odbioru. Usługa spełnia ustalone warunki techniczne i biznesowe, a rozbieżności są wyjaśnione lub objęte jawną decyzją ograniczającą uruchomienie. Jeżeli nie osiągnięto celu RTO albo brakuje podstaw do oceny utraty danych, zapisuje się ten wynik wprost. Udany test pobrania archiwum nie zastępuje próby odtworzenia procesu sprzedażowego.
Ograniczenie wniosku. Ćwiczenie potwierdza konkretny punkt kopii i warunki testowe. Nie dowodzi automatycznie integralności wszystkich archiwów ani gotowości każdego pracownika. Kolejną próbę warto dobrać tak, aby zbadała inną istotną zależność: odzyskanie klucza, brak głównego administratora albo zmianę systemu zamówień. Taki sposób projektowania ćwiczeń jest propozycją, którą każdy sklep może dopasować do własnych potrzeb.
Rozdział 22Bezpieczne zmiany: jak nie przywrócić podatności przy aktualizacji
Skuteczna naprawa traci wartość, jeśli następne wdrożenie przywraca poprzedni plik, zbyt szerokie uprawnienia albo niesprawdzony fragment kodu. Dlatego audytowi aplikacji powinna towarzyszyć ocena procesu zmian. NIST SSDF 1.1 opisuje praktyki bezpieczeństwa, które można włączyć w cykl wytwarzania oprogramowania. Nie wiąże ich z jednym narzędziem ani z jednym modelem pracy zespołu.[82]
Warunki dopuszczenia zmiany do produkcji
Proponujemy traktować zmianę wtyczki, checkoutu lub własnego kodu jako decyzję z czterema warunkami. Trzeba wiedzieć, co zostanie wdrożone, jakie ryzyko sprawdzono, jak rozpoznamy błąd i jak wycofamy zmianę. W prostym serwisie wystarczy zwięzła karta. W większym sklepie część dowodów może powstawać automatycznie podczas budowania i testowania.
Pierwszy warunek to identyfikowalny pakiet zmiany: wersja, źródło, osoba zatwierdzająca i zależności. Drugi to testy dobrane do rzeczywistego wpływu zmiany. Zmiana eksportu wymaga ponownego sprawdzenia izolacji dokumentów, a zmiana obsługi płatności także scenariusza ponowień. Trzeci to obserwacja po wdrożeniu, która obejmuje odpowiedź serwera i objawy błędu. Czwarty to wykonalny plan odwrotu, uwzględniający migracje danych.
Wycofanie plików nie zawsze oznacza wycofanie zmiany. W proponowanym procesie osobno ocenia się odwracalność zmian w bazie, w formatach wiadomości i w zleceniach przekazanych integracjom. Jeśli powrót do poprzedniego kodu wymaga starego schematu danych, trzeba przewidzieć kontrolowaną ścieżkę przywracania lub naprawy do przodu. Tę zależność trzeba rozpoznać przed wdrożeniem, zanim ujawni ją awaria.
Przegląd kodu, testy i analiza zależności odpowiadają na różne pytania
Analiza statyczna kodu, czyli SAST, szuka wzorców w kodzie. Analiza składu oprogramowania, czyli SCA, pomaga identyfikować komponenty i znane problemy z nimi związane. Testy działającej aplikacji, czyli DAST, sprawdzają zachowanie dostępnych ścieżek. Żadne z tych podejść samo nie dowodzi poprawności wszystkich reguł biznesowych. OWASP opisuje wykorzystanie kontroli bezpieczeństwa w procesie CI/CD i potrzebę ochrony samego środowiska budowania i wdrażania.[22]
W WordPressie przeglądem warto objąć także kod zapisany we wtyczkach do zarządzania snippetami, w motywie potomnym i w rozszerzeniach tworzonych na zamówienie. Proponowany warunek odbioru nie zależy od autora kodu. Zmiana przygotowana przez pracownika, dostawcę lub z pomocą modelu AI przechodzi taką samą ocenę uprawnień, danych i skutków. Sam sposób powstania kodu nie dowodzi podatności i nie zwalnia z weryfikacji.
Aktualizacja awaryjna z zachowaniem odpowiedzialności
Tryb pilny skraca drogę decyzyjną i zachowuje jej podstawowe etapy. Przykładowa karta awaryjna zawiera powód, zasób, osobę zatwierdzającą, zakres krótkich testów, ograniczenia i termin uzupełnienia weryfikacji. Przy aktywnie wykorzystywanej podatności można najpierw ograniczyć dostęp do zagrożonej funkcji. Trzeba wtedy zapisać, co wyłączono i którego procesu biznesowego to dotknęło.
Po wdrożeniu warto utrwalić test regresyjny, czyli próbę, która wykryje powrót naprawionego błędu. Dla AUD-01 test wykonuje próbę dostępu między klientami i oczekuje odmowy. Samo sprawdzenie obecności zmienionej linijki kodu jest tu niewystarczające. Trzeba też wyznaczyć właściciela testu. Test przechowywany w repozytorium i niewykonywany nie daje aktualnego potwierdzenia.
Rozdział 23Pochodzenie kodu: od listy wtyczek do kontroli artefaktu wdrożeniowego
Lista nazw i wersji dodatków jest potrzebna, choć opisuje tylko część zawartości wdrożenia. Osobnej identyfikacji mogą wymagać własny motyw, biblioteki dostarczone z wtyczką, zbudowany frontend i ręczne zmiany na serwerze. SBOM, czyli zestawienie składników oprogramowania, porządkuje wiedzę o komponentach. Sam spis nie dowodzi jednak, że aplikacja jest wolna od podatności ani że na produkcji działa właśnie opisana zawartość.[98]
Cztery pytania o każdy istotny komponent
W proponowanym rejestrze zapisujemy, skąd pochodzi komponent, co dokładnie wdrożono, kto może wydać następną wersję i jak organizacja reaguje na zakończenie wsparcia. W przypadku dodatku premium oznacza to m.in. ustalenie legalnego źródła dystrybucji i osoby odpowiedzialnej za dostęp do aktualizacji. Dla własnego rozszerzenia potrzebne jest powiązanie repozytorium, przeglądu zmiany, pakietu wdrożeniowego i instalacji produkcyjnej.
Mała witryna i rozbudowany system sprzedażowy wymagają różnego zakresu dokumentacji. Minimalny model może wskazywać zatwierdzone źródło, wersję, skrót otrzymanego pakietu i właściciela utrzymania. W większym rozwiązaniu warto powiązać te dane z informacją o procesie budowania. SLSA opisuje pochodzenie artefaktu, w tym dane o budowaniu i jego wejściach. Taka informacja uzupełnia test podatności gotowej aplikacji i odpowiada na osobne pytanie.[97]
Integralność i zaufane pochodzenie to osobne kwestie
Skrót pliku pozwala porównać dwie zawartości. Jeżeli jednak wzorzec i pakiet pochodzą z tego samego niezaufanego miejsca, ich zgodność nie rozstrzyga o autentyczności źródła. Poprawny podpis również wymaga interpretacji: czy pochodzi od oczekiwanego wystawcy, czy dotyczy właściwego artefaktu i czy proces dopuszcza takie źródło? W proponowanym audycie zapisujemy osobno wynik porównania i podstawę zaufania.
W WordPressie użyteczny scenariusz obejmuje porównanie zatwierdzonego wydania własnego dodatku z instalacją produkcyjną, łącznie z plikami pozostałymi po poprzedniej wersji. Oczekiwany wynik obejmuje zgodność nagłówka „Version” i wyjaśnienie wszystkich różnic. Trzeba potwierdzić akceptację tych różnic i określić, czy wynik wcześniejszego audytu nadal dotyczy działającego kodu.
Brak informacji o podatności nie dowodzi braku problemu
Komponent może nie mieć znanego wpisu CVE, a mimo to wymagać przeglądu własnego kodu lub konfiguracji. Odwrotna sytuacja również wymaga analizy: pasujący wpis nie potwierdza automatycznie, że problem jest osiągalny w danej konfiguracji. W modelu decyzyjnym rozdzielamy identyfikację składnika, dopasowanie wersji, warunki wykorzystania i dowód ograniczenia ekspozycji. Te kontrole obowiązują niezależnie od źródła kodu, także wtedy, gdy powstał z pomocą narzędzia generatywnego.
Własny rejestr powinien wskazywać, które biblioteki rozpoznano automatycznie, które ręcznie, a które pozostają nierozstrzygnięte. Raport nie może utożsamiać komunikatu „narzędzie nie rozpoznało zależności” ze stwierdzeniem „zależność nie występuje”. Przy odtwarzaniu po incydencie ta zasada ma szczególne znaczenie, bo celem jest uruchomienie zatwierdzonej zawartości. To, że jakaś kopia daje się włączyć, nie potwierdza jej pochodzenia.
Narzędzie audytowe również ma granice zaufania
W planie prac warto ustalić, czy dana komenda analizuje pliki, czy uruchamia środowisko i kod aplikacji. Przy podejrzeniu przejęcia nie należy bez oceny zakładać zaufania do lokalnego środowiska ani podłączać do niego uprzywilejowanych sekretów. Dobór analizy statycznej, izolowanej kopii i dalszych czynności trzeba uzgodnić z osobą prowadzącą reakcję. Opisane podejście dotyczy planowania bezpiecznej pracy, a konkretne polecenia do uruchomienia na produkcji dobiera się do sytuacji.
Wynikiem tej części audytu jest możliwość wskazania: „ten wynik dotyczy tego artefaktu, z tego źródła, wdrożonego w tym środowisku”. Bez takiego powiązania nawet dobry raport może opisywać wersję, która już nie działa na stronie.
Rozdział 24Dostawcy i tożsamości: kto faktycznie kontroluje stronę?
Witryna zależy od organizacji, których nie widać na jej stronie głównej. Hosting, poczta odzyskiwania, rejestrator, producent wtyczki, operator kopii i dostawca tagów mogą w różnym stopniu wpływać na poufność, dostępność i możliwość wprowadzania zmian. NIST SP 800-161 Rev. 1 opisuje zarządzanie ryzykiem łańcucha dostaw w całym cyklu korzystania z produktów i usług. W tym artykule traktujemy go jako punkt odniesienia dla dobrowolnie projektowanej praktyki. Nie twierdzimy, że istnieje powszechny obowiązek wdrożenia tego amerykańskiego standardu.[83]
Rejestr dostawcy kończy się decyzją
Proponowany wpis obejmuje usługę, zakres danych, poziom dostępu, właściciela po stronie firmy, sposób zgłaszania incydentu i możliwość odzyskania zasobów. Przy wtyczce warto dodać źródło pakietu i licencji, politykę wsparcia oraz alternatywę na wypadek porzucenia rozwoju. Przy hostingu dochodzą zakres kopii, dostępność potrzebnych logów i warunki uzyskania pomocy w awarii. Wpis służy ustaleniu, jakie ryzyko pozostaje po stronie klienta, więc dokumenty zbiera się pod tym kątem.
Deklarację dostawcy trzeba porównać z tym, co faktycznie objęto usługą. Hasło „codzienne kopie” może wymagać doprecyzowania: jakie dane, jaka retencja, czy dostęp zostaje zachowany po przejęciu konta i kto może uruchomić odtworzenie? Raport z oceny dostawcy trzeba też uzupełnić sprawdzeniem konfiguracji naszego środowiska. W takim dokumencie najwięcej mówią zakres, okres objęty oceną i wyłączenia, a samo logo programu certyfikacyjnego ich nie opisuje.
Zakończenie współpracy jest scenariuszem bezpieczeństwa
Proponowana próba odejścia administratora obejmuje konto WordPressa, aktywne sesje, SSO, klucze SSH, hosting, repozytorium, kopie, DNS, menedżer tagów i konta używane do odzyskiwania dostępu. Lista wynika z rzeczywistej architektury i w danej instalacji może być krótsza. Test powinien wykazać, że osoba po odejściu nie może już wykonać operacji, do których wcześniej miała dostęp. Usunięcie nazwiska z panelu jest jednym z elementów tej próby.
W przypadku haseł aplikacji WordPressa dokumentacja przewiduje oddzielne, odwoływalne poświadczenia przypisane do konta użytkownika. Dlatego zamknięcie dostępu integracyjnego trzeba sprawdzić niezależnie od zmiany hasła do logowania przez przeglądarkę. Raport powinien jasno wskazywać, które poświadczenie odwołano i czy legalna integracja otrzymała kontrolowany zamiennik.[70]
Menedżer tagów jest drogą publikacji kodu
Skrypt dostawcy uruchamiany na stronie może zmieniać jej zachowanie i uzyskiwać dostęp do informacji dostępnych w jej kontekście. OWASP wskazuje ryzyko utraty kontroli nad zmianami, wykonania obcego kodu i ujawnienia danych. Sama warstwa danych marketingowych nie jest piaskownicą ograniczającą uprawnienia skryptu.[20]
W proponowanej kontroli każda publikacja tagu ma właściciela, cel i zatwierdzony zakres stron. Audyt obejmuje konto wydawcy, historię zmian i próbę wycofania testowej modyfikacji. W checkoucie trzeba też sprawdzić, czy skrypt jest tam rzeczywiście potrzebny. Pomiar zgody marketingowej, kontrola uprawnień do publikacji i bezpieczeństwo wykonywanego kodu to trzy osobne zadania.
Plan wyjścia od dostawcy
Praktycznym testem niezależności jest uzgodnione przekazanie zasobów: domeny, eksportu danych, repozytorium, licencji możliwych do przeniesienia i instrukcji uruchomienia. Trzeba ustalić, co pozostaje własnością dostawcy i jakie ograniczenia wynikają z umowy. Pełnej przenoszalności wszystkich usług nie można zakładać z góry. Ryzyko rośnie szczególnie wtedy, gdy jedyna kopia, jedyne konto odzyskiwania i jedyna dokumentacja są pod kontrolą jednej osoby spoza firmy.
Proponowany rezultat audytu to lista krytycznych zależności z decyzją: pozostawiamy i monitorujemy, ograniczamy dostęp, przygotowujemy alternatywę albo zmieniamy dostawcę. Bez takiego zakończenia przegląd dostawców pozostaje opisem stanu, którym nie da się zarządzać.
Rozdział 25Dashboard bezpieczeństwa: mierz dowody i ich aktualność
Dashboard odpowiada właścicielowi strony na trzy pytania bez codziennej lektury wszystkich logów: które najważniejsze zabezpieczenia mają aktualny dowód, gdzie występuje nierozstrzygnięte ryzyko i która decyzja się opóźnia. NIST SP 800-137 opisuje ciągłe monitorowanie jako element utrzymywania świadomości stanu bezpieczeństwa. Częstotliwość obserwacji i weryfikacji dostosowuje się do charakteru zasobów i ryzyka.[84]
Cztery osobne wyniki stanu bezpieczeństwa
Proponujemy oddzielić pokrycie badania, wynik kontroli, wiek dowodu i stan naprawy. Można mieć wysoki udział wykonanych prób i jednocześnie otwartą krytyczną lukę. Można też mieć dobry wynik sprzed kilku miesięcy, który nie opisuje nowej wersji checkoutu. Jeden kolor łączący te sytuacje ukrywa informację potrzebną do decyzji.
| Miara (propozycja własna) | Sposób liczenia lub oceny | Ważne ograniczenie |
|---|---|---|
| Pokrycie uzgodnionych kontroli | Kontrole zakończone rozstrzygnięciem / wszystkie mające zastosowanie. | „Nie zweryfikowano” pozostaje w mianowniku; „nie dotyczy” wymaga uzasadnienia. |
| Aktualne potwierdzenie działania | Kontrole spełnione z nadal adekwatnym dowodem / wszystkie mające zastosowanie. | Nie jest prawdopodobieństwem uniknięcia włamania. |
| Czas ograniczenia ekspozycji | Czas od przyjęcia wiarygodnego zgłoszenia do potwierdzonego ograniczenia ryzyka. | Liczy się go osobno od terminu trwałej naprawy. |
| Skuteczność odtwarzania | Wynik ćwiczenia wobec uzgodnionych RPO, RTO i kryteriów biznesowych. | Kopia ukończona bez błędu nie potwierdza tego wyniku. |
| Stan ryzyk otwartych | Istotne ustalenia według priorytetu, właściciela i terminu decyzji. | Liczba zamkniętych zadań nie pokazuje automatycznie spadku ryzyka. |
Jak uniknąć mylącego mianownika
Wyłącznie hipotetyczny przykład: plan obejmuje 40 kontroli, a dla 4 wykazano, że nie mają zastosowania. Spośród pozostałych 36 rozstrzygnięto 28: 22 są spełnione, 4 niespełnione, a 2 częściowo spełnione. Osiem pozostaje niezweryfikowanych. Pokrycie wynosi 28/36, czyli 77,8%. Udział kontroli spełnionych to 22/36, czyli 61,1%, pod warunkiem że wszystkie 22 dowody są nadal aktualne. Żaden z tych wyników nie oznacza, że „strona jest bezpieczna w 61,1%”.
Gdy po zmianie konfiguracji trzy dowody przestają być adekwatne, udział aktualnie potwierdzonych kontroli spada do 19/36, czyli 52,8%. Te trzy zabezpieczenia wymagają wtedy ponownego potwierdzenia, choć mogą nadal działać. Taka interpretacja pozwala uczciwie komunikować niewiedzę i nie nazywać jej automatycznie podatnością.
Kiedy dowód przestaje odpowiadać na pytanie
Proponowany rejestr przypisuje dowód do wersji, środowiska, ustawień i daty. Oprócz terminu przeglądu wskazuje zdarzenia, które wyzwalają ponowną ocenę: zmianę wtyczki realizującej kontrolę dostępu, migrację hostingu, zmianę cache, dodanie tagu na stronie płatności albo zmianę sposobu przechowywania kopii. Wcześniejszy raport pozostaje wtedy dokumentem historycznym i przestaje być pełnym potwierdzeniem nowego stanu.
Zakres przeglądu dobiera się do zmiany i jej zależności, więc przegląd nie musi oznaczać ponownego zakupu całego audytu. Istotne jest uzasadnienie: dlaczego wystarcza konkretna próba i które obszary pozostają niezmienione. Przy zmianie architektury lub wielu współzależnych elementów częściowy retest może okazać się niewystarczający.
Rozmowa zarządcza kończy się decyzją
Miesięczny przegląd można oprzeć na trzech pytaniach: co istotnego zmieniło ryzyko, która kontrola straciła aktualny dowód i czego potrzebuje właściciel naprawy? Proponowany zapis spotkania wskazuje decyzję, osobę odpowiedzialną, termin i sposób potwierdzenia. W małej firmie może to być jeden akapit, bez rozbudowanego działu bezpieczeństwa.
Trzeba oddzielić czas reakcji na alarm, czas potwierdzenia incydentu, czas ograniczenia ekspozycji i czas trwałej naprawy. Te zegary mają różne początki i zakończenia. Nie należy porównywać ich między zespołami bez wspólnej definicji ani utożsamiać wewnętrznego terminu technicznego z terminem zgłoszenia wynikającym z przepisów.
Rozdział 26Od raportu do utrzymania: przykładowy plan 30–60–90 dni
Poniższy plan porządkuje prace po audycie i nie odracza pilnych napraw. Aktywne incydenty i problemy krytyczne obsługuje się od razu, niezależnie od harmonogramu. Plan obejmuje zamknięcie pojedynczych ustaleń i usunięcie przyczyn, przez które wracają.
Pierwsze 30 dni: odzyskanie kontroli. Ustal właścicieli systemów i dostępów, ogranicz potwierdzone zagrożenia, przygotuj pilne aktualizacje i sprawdź możliwość odtworzenia najważniejszych danych. Każde istotne ustalenie powinno mieć decyzję, osobę odpowiedzialną i termin. Na tym etapie warto też uporządkować zgłaszanie problemów krytycznych poza godzinami pracy.
Do 60 dni: usunięcie przyczyn. Dokończ poprawki wymagające zmian w kodzie lub konfiguracji, wycofaj zbędne komponenty, uporządkuj uprawnienia i przetestuj integracje. Sprawdź, czy wdrożenia mają przewidywalną ścieżkę zatwierdzania, testowania i ewentualnego wycofania. Pierwszeństwo mają problemy systemowe, które mogą ponownie wprowadzić tę samą kategorię błędu.
Do 90 dni: potwierdzenie skuteczności. Zamknij retesty, przeprowadź ćwiczenie reagowania i powtórz uzgodniony test odtwarzania. Dla nieusuniętych ryzyk przygotuj formalną decyzję i datę następnego przeglądu. Zaktualizuj zakres kolejnych audytów tak, by obejmował wprowadzone funkcje, nowe role i integracje.
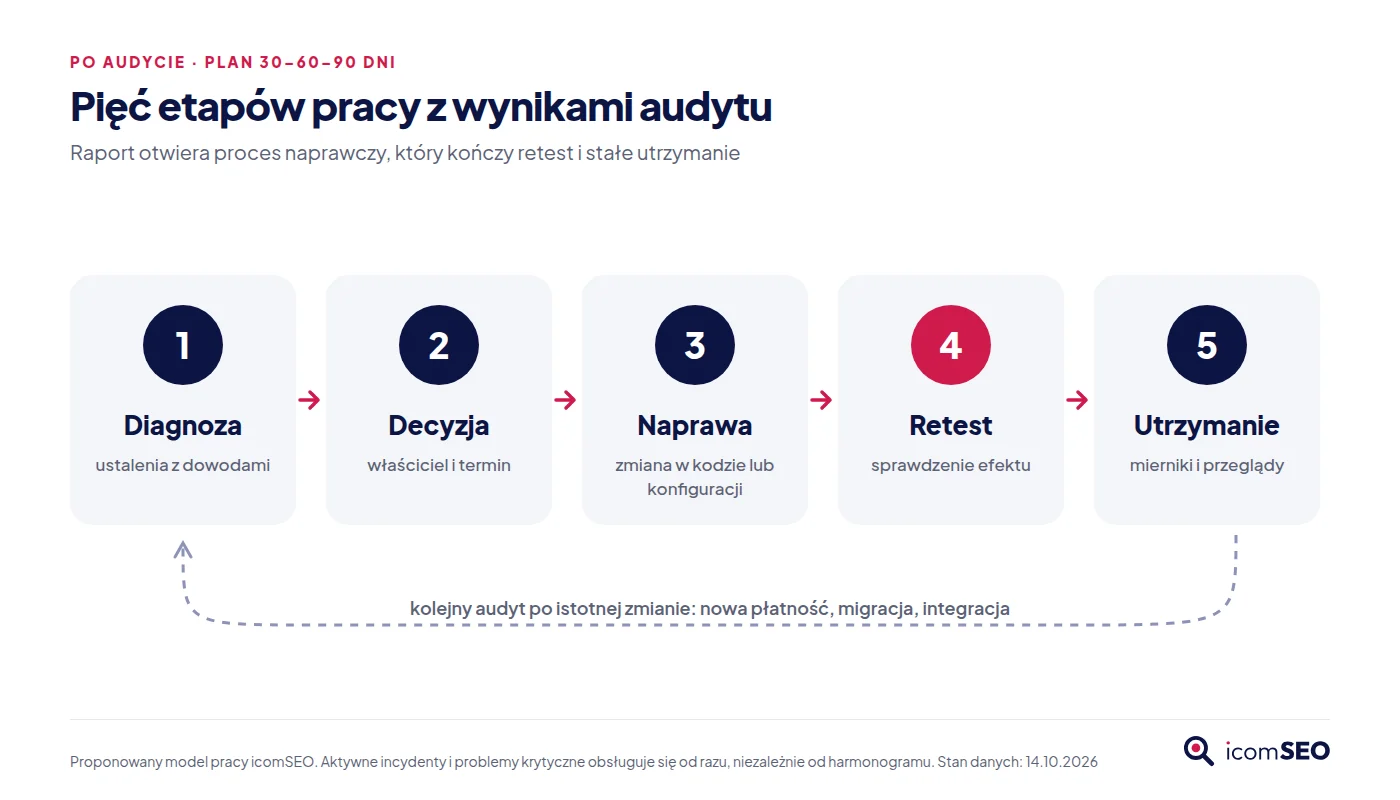
Mierniki, które warto umieścić w przeglądzie zarządczym
W przeglądzie zarządczym proponujemy mierzyć stan zabezpieczeń i wykonanie decyzji. Liczba zablokowanych botów niewiele mówi o jednym i drugim. Każdy wskaźnik musi mieć zdefiniowany zakres, mianownik, okres i źródło danych. Bez tego informacja „95% zgodności” może ukrywać brak oceny najważniejszej części systemu.
| Proponowany miernik | Co należy dokładnie zdefiniować? |
|---|---|
| Udział kont uprzywilejowanych objętych wymaganym MFA | Zbiór kont w CMS i we wszystkich pozostałych uzgodnionych systemach. |
| Udział aktywnych komponentów z potwierdzonym opiekunem i wsparciem | Pełną inwentaryzację, sposób potwierdzania wsparcia i datę oceny. |
| Udział ustaleń wysokiego priorytetu zamkniętych retestem w terminie | Termin uzgodniony dla każdego ustalenia i rozdzielenie napraw od akceptacji ryzyka. |
| Wynik testów odtworzenia względem RPO i RTO | Rzeczywisty zakres testu, odzyskany punkt danych i czas przywrócenia. |
| Pokrycie uzgodnionych scenariuszy testami | Liczbę scenariuszy wykonanych oraz osobno wyłączenia i obszary niezweryfikowane. |
Warto też obserwować powracające przyczyny. Jeżeli po kolejnych wdrożeniach wracają te same błędy uprawnień, oprócz następnej poprawki potrzebna jest zmiana sposobu projektowania, przeglądu i testowania tej kategorii funkcji.
Rozdział 27Reagowanie i odpowiedzialność: sprawdź, czy ktoś potrafi zadziałać
NIST SP 800-61 Rev. 3 ujmuje reagowanie na incydenty jako element zarządzania ryzykiem, obecny także przed awarią. Szerszy NIST CSF 2.0 pozwala uporządkować zarządzanie, identyfikację, ochronę, wykrywanie, reagowanie i odtwarzanie. Dla właściciela strony to użyteczna perspektywa, bo raport z podatnościami odpowiada tylko na część potrzeb organizacji.[65][66]
Próba alarmu: od zdarzenia do osoby odpowiedzialnej
W proponowanym ćwiczeniu tworzymy uzgodnione zdarzenie testowe, np. zmianę uprawnienia konta szkoleniowego. Następnie sprawdzamy rejestrację, wysłanie alarmu, odbiór, kwalifikację i eskalację. Sam komunikat „powiadomienie wysłane” nie dowodzi, że powiadomienie trafiło do osoby zdolnej zareagować. Wynikiem ćwiczenia powinna być oś czasu i informacja, na którym etapie proces przestał działać zgodnie z oczekiwaniami.
W wariancie rozszerzonym testujemy też sytuację, w której zwykły kanał jest niedostępny: nie działa poczta firmowa, potrzebna osoba jest na urlopie albo konto używane do zgłoszeń zostało przejęte. To ćwiczenie organizacyjne nie wymaga rzeczywistego włamania. Pozwala sprawdzić numery awaryjne, uprawnienia do zatrzymania usługi i dostęp do dokumentacji poza podstawowym środowiskiem.
Ćwiczenie decyzyjne z trzema etapami
Etap pierwszy: sygnał. Klient zgłasza nieoczekiwane przekierowanie. Zespół rejestruje zgłoszenie, ustala fakty i wyznacza osobę prowadzącą. Bez dowodów nie publikuje jeszcze komunikatu o „wycieku całej bazy”.
Etap drugi: niepewność. Pojawia się nieznane konto uprzywilejowane i luka w logach. Uczestnicy wybierają działania ograniczające ryzyko, sposób zachowania dowodów i zakres dalszej weryfikacji. Równolegle ustalają, kto oceni możliwe naruszenie danych i obowiązki komunikacyjne.
Etap trzeci: przywrócenie. Dostępny jest punkt kopii, ale po jego utworzeniu złożono zamówienia. Zespół decyduje o warunkach bezpiecznego odtworzenia, uzgodnieniu rozliczeń i ponownym otwarciu sprzedaży. Celem jest kontrolowane wznowienie uzgodnionych funkcji, nawet jeśli strona główna mogłaby wrócić szybciej.
To fikcyjny scenariusz redakcyjny. Jego rezultatem są wykryte luki procesu, przypisane zadania i powtórka nieskutecznych etapów. Przy ocenie próby warto osobno mierzyć czas technicznego przywrócenia, czas podjęcia decyzji i dostępność kompetentnych osób.
Właściciel ryzyka, wykonawca naprawy i weryfikator to osobne role
Proponowany podział jest prosty. Właściciel biznesowy ustala akceptowalny skutek i zatwierdza pozostawienie ryzyka. Zespół techniczny wdraża naprawę. Audytor lub wyznaczony weryfikator sprawdza rezultat. Hosting odpowiada za uzgodnioną część infrastruktury, a agencja za uzgodnione utrzymanie aplikacji. Osoba odpowiedzialna za ochronę danych wspiera ocenę naruszeń i obowiązków, a odpowiedzialność administratora danych pozostaje przy administratorze.
Ten model trzeba dopasować do umów i skali organizacji. W małej firmie jedna osoba może pełnić kilka ról, a decyzje i tak trzeba rozróżniać. Przy istotnych poprawkach warto zapewnić drugą ocenę ich skuteczności. Chroni ona przed sytuacją, w której zmianę uznaje za skuteczną wyłącznie jej wykonawca, bez sprawdzenia. Nie wymaga to tworzenia nowych stanowisk.
Zgłaszanie podatności po zakończeniu audytu
Plik security.txt opisany w RFC 9116 pomaga wskazać kanał kontaktu i politykę zgłaszania podatności. Sam w sobie nie jest zgodą na nieograniczone testy ani obietnicą nagrody. Powinien odsyłać do aktualnej, obsługiwanej ścieżki kontaktu.[67]
W proponowanym procesie każde zgłoszenie otrzymuje potwierdzenie odbioru, ocenę wiarygodności i decyzję o dalszym działaniu. Informacja dotycząca zewnętrznej wtyczki może wymagać kontaktu z jej producentem. Polityka chroni klientów serwisu i poufność szczegółów technicznych przed nieuprawnionymi osobami. Taki proces uzupełnia okresowy audyt i bieżące utrzymanie.
Rozdział 28Jak zamówić audyt i porównać oferty bez pozornych oszczędności?
Sama cena mówi niewiele, gdy jedna oferta obejmuje skan publicznego adresu, a druga testy kilku ról, przegląd własnego kodu i odtworzenie kopii. Proponujemy najpierw ujednolicić zakres: domeny, aplikacje, role, integracje, dostęp do konfiguracji, oczekiwane dowody i retest. Nakład pracy i wycenę zestawia się dopiero na tej podstawie.
Na początku do przygotowania rzetelnej oferty wystarczy opis funkcji, technologii, liczby ról i integracji oraz celu badania. Zapytanie ofertowe nie wymaga wysyłania haseł ani pełnej bazy danych. Dostępy przekazuje się dopiero w uzgodnionym trybie realizacji, z odpowiednimi ograniczeniami.
W rozmowie z wykonawcą warto doprecyzować trzy rzeczy: co dokładnie sprawdzi, jak pokaże dowód i kto zweryfikuje naprawy. Trzeba też uzgodnić sposób eskalacji problemu krytycznego, ochronę raportu i warunki ponownego testu. Zapowiedź „otrzymasz kilkadziesiąt stron PDF” nie opisuje jeszcze jakości usługi.
Częstotliwość kolejnych przeglądów proponujemy powiązać ze zmianami i ryzykiem. Nowa bramka płatnicza, rozszerzenie uprawnień, migracja, integracja z CRM czy własny moduł eksportu to sygnał do oceny odpowiednich scenariuszy. Nie trzeba przy tym czekać na arbitralną rocznicę poprzedniego audytu. Szczególne wymagania prawne i kontraktowe uwzględnia się oddzielnie.
Przed odbiorem raportu przydaje się wspólne omówienie ustaleń z właścicielem biznesowym, administratorem i wykonawcą zmian. Takie spotkanie pomaga odróżnić faktyczny problem od nieporozumienia co do działania funkcji, przypisać zadania i ustalić dowody potrzebne do zamknięcia. Omówienie służy zgodnemu rozumieniu faktów. Ocena ryzyka nie jest przedmiotem negocjacji.
Co ustalić przed podpisaniem zlecenia
Początek prac warto powiązać z osiągnięciem gotowości do testów, niezależnie od daty płatności. Proponowane warunki wejścia to zatwierdzony zakres, upoważnienie, aktywne konta testowe, kontakt awaryjny i uzgodnione ograniczenia. Jeżeli któregoś elementu brakuje, wykonawca wskazuje wpływ na harmonogram i zakres wniosków.
Warunki odbioru również zapisuje się z wyprzedzeniem. Proponujemy wymagać kompletnego rejestru wykonanych scenariuszy, rozróżnienia ustaleń i podejrzeń, dowodów dla istotnych problemów, listy ograniczeń oraz omówienia planu napraw. Retest musi mieć określony zakres, środowisko i sposób raportowania. Funkcje dodane w trakcie prac przechodzą przez jawną zmianę zakresu. Żadna z nich nie powinna znikać z oceny bez komentarza.
Informacje, których warto oczekiwać w wycenie
Cena powinna uwzględniać liczbę różnych mechanizmów i przepływów. Sama liczba adresów URL słabo opisuje pracochłonność. Sto podobnych stron treściowych może korzystać z jednego mechanizmu. Z kolei jedna funkcja importu z uprawnieniami, przetwarzaniem plików i zewnętrzną integracją może wymagać kilku odrębnych scenariuszy. Ten przykład uzasadnia proponowany sposób porównywania zakresów i nie opisuje stawek rynkowych.
W ofercie warto osobno wskazać przegląd kodu, odtwarzanie, ocenę organizacyjną, testy integracji i retest. Należy też ustalić, kto usuwa dane testowe, odwołuje konta audytora i potwierdza zakończenie dostępu. Domknięcie uprawnień jest obowiązkową częścią zakończenia współpracy i nie powinno czekać do następnego projektu.
Rozdział 29Najczęstsze pytania właścicieli stron na WordPressie
Czy aktualny WordPress oznacza, że strona jest bezpieczna?
Aktualność rdzenia to jeden z wielu elementów oceny i sama nie dowodzi bezpieczeństwa. Audyt obejmuje również wtyczki, motywy, własny kod, konta, integracje i konfigurację. Aktualizacje są częścią ochrony i stanowią tylko jedną z pozycji wyniku audytu. Wybór zarządzanego hostingu nie zdejmuje z właściciela aplikacji jego zakresu odpowiedzialności.[7][9]
Czy wtyczka ochronna może zastąpić audyt?
Wtyczka może realizować wybrane mechanizmy. Audyt ocenia ich skuteczność oraz obszary, których nie obejmują. Deklaracja producenta nie potwierdza poprawności własnej logiki zwrotów, uprawnień do dokumentów ani zdolności odtworzenia sklepu. Ten wniosek wynika z rozdzielenia niezależnych zakresów kontroli.[12][34][39]
Czy warto blokować całe REST API i wszystkie funkcje zdalne?
Decyzja wymaga najpierw rozpoznania, do czego te funkcje służą. Publicznie dostępny endpoint może być zamierzonym elementem WordPressa. Należy sprawdzić jego przeznaczenie, dane i uprawnienia, a potem ograniczyć funkcje zbędne lub źle zabezpieczone. Całościowa blokada może zerwać legalne zależności aplikacji.[26]
Czy test zewnętrzny wystarczy do sprawdzenia kopii i konfiguracji?
Test zewnętrzny nie powinien być przedstawiany jako dowód właściwości, których nie dało się zbadać. W proponowanym raporcie trzeba wskazać, że kopie, ustawienia wewnętrzne lub część ról pozostają poza oceną. Aby je objąć, zakres poszerza się o odpowiednie dostępy, dokumenty lub kontrolowany test.
Czy audyt daje gwarancję zgodności z przepisami?
Czy sam certyfikat poprawi SEO i sprzedaż?
Co zrobić, gdy audyt wykryje aktywne włamanie?
Uzgodniony tryb reagowania uruchamia się od razu, przed przygotowaniem dokumentu końcowego. Należy ograniczyć incydent, zabezpieczyć potrzebne dowody, odzyskać kontrolę i ocenić obowiązki dotyczące danych. Konkretne działania techniczne dobiera się do zdarzenia, aby nie zniszczyć informacji potrzebnych do jego wyjaśnienia.[39][43]
Kiedy można uznać problem za zamknięty?
W proponowanym modelu wtedy, gdy istnieje uzgodniony dowód skuteczności naprawy w odpowiednim środowisku albo formalna decyzja o innym sposobie postępowania z ryzykiem. Przypisanie zadania, deklaracja wykonawcy czy zniknięcie alertu nie wystarczają do statusu „naprawiono”.
Czy wysoki wynik skanera może być kryterium odbioru?
Wynik skanera jest jednym z sygnałów i uzupełnia uzgodnione testy. Proponowane kryterium odbioru odnosi się do zachowania aplikacji i kompletności dowodów. Wynik narzędzia interpretuje się razem z metodą, konfiguracją i zakresem. Brak alertów nie oznacza automatycznie, że wykonano próby izolacji klientów lub przywrócenia kopii.
Czy wszystko trzeba testować na produkcji?
Miejsce testu dobiera się do celu i ryzyka operacyjnego. W proponowanym modelu testy, które mogą zmieniać dane lub zakłócać pracę, zaczyna się w uzgodnionym środowisku i dokumentuje reprezentatywność jego konfiguracji. Wybrane właściwości produkcji wymagają osobnego potwierdzenia. Nawet wtedy nie wykonuje się nieuzgodnionych prób obciążeniowych ani operacji płatniczych.
Czy raport można opublikować na stronie jako dowód bezpieczeństwa?
Publiczny opis zakresu i daty przeglądu może być elementem komunikacji. Pełny raport może jednak zawierać informacje wrażliwe. Proponujemy osobną, zredagowaną wersję podsumowania, bez sekretów, danych klientów i szczegółów otwartych podatności. Opis powinien wskazywać zakres i ograniczenia przeglądu oraz unikać sugestii bezterminowej gwarancji odporności.
Rozdział 30Audyt pod audytem: kontrola jakości, niezależność i granice zapewnienia
Profesjonalizm usługi można ocenić także wtedy, gdy raport nie zawiera spektakularnej podatności. Kryterium stanowią wykonany zakres, adekwatność scenariuszy i wiarygodność wniosków. Obok pytania „ile błędów znaleziono?” warto zadać drugie: „jaki dowód mógłby podważyć ten wniosek i czy go sprawdzono?”. Poniższy model przeglądu jest propozycją icomSEO i nie ma statusu standardu certyfikacyjnego.
Najpierw odbiór zakresu, potem wniosków
Pierwszy przegląd porównuje uzgodnione zasoby, role, funkcje i metody z tym, co faktycznie wykonano. Niewykonany test pozostaje niewykonany także wtedy, gdy audytor znalazł inne istotne problemy. Zmiany zakresu mają datę i zatwierdzenie. Po zakończeniu prac nie wolno zmniejszać mianownika, aby poprawić wskaźnik pokrycia.
Drugi przegląd dotyczy relacji między obserwacją a wnioskiem. Czy odmowa dostępu wynikała z właściwej kontroli, czy z niedziałającej funkcji? Czy konto, które powinno mieć dostęp, potrafiło wykonać operację? Czy blokady WAF nie opisano błędnie jako naprawy aplikacji? W razie wątpliwości raport oddziela potwierdzone zachowanie od przypuszczenia o jego przyczynie.
| Twierdzenie w raporcie | Pytanie kontrolne | Uczciwe ograniczenie wniosku |
|---|---|---|
| „Nie wykryto dostępu do cudzych dokumentów”. | Jakie role, dokumenty i kanały sprawdzono? | Wynik dotyczy wyłącznie wymienionej próby; przyszłe przypadki wymagają osobnej oceny. |
| „Przywracanie działa”. | Czy uruchomiono usługę, czy tylko rozpakowano archiwum? | Potwierdzono dokładnie wskazany etap i zakres danych. |
| „MFA chroni administrację”. | Które panele, integracje i ścieżki odzyskiwania zbadano? | Kanały nieweryfikowane pozostają osobną pozycją ryzyka. |
| „Podatność naprawiono”. | Czy przebadano wdrożony kod i alternatywne ścieżki? | Odbiór dotyczy określonej wersji i warunków retestu. |
Granice wniosków z próby celowej
Przypuśćmy, że audytor wybrał 20 szczególnie istotnych scenariuszy i wszystkie dały oczekiwany wynik. Można wtedy stwierdzić, że tych 20 prób zakończyło się prawidłowo. Z samego tego wyniku nie da się obliczyć prawdopodobieństwa, że „cała strona jest bezpieczna”, ani przypisać jej statystycznego przedziału ufności. Dobór celowy, zależności między próbami i zmienność aplikacji nie spełniają automatycznie założeń losowej próby niezależnych zdarzeń.
Pokrycie da się jednak mierzyć. Warto pokazać, które kombinacje roli, operacji, właściciela danych, interfejsu i stanu procesu zbadano. Scenariusze uznane za równoważne wymagają uzasadnienia. Przykładowo test dwóch widoków korzystających z tej samej kontroli może być reprezentatywny tylko wtedy, gdy potwierdzono, że oba faktycznie przechodzą przez tę kontrolę i nie mają dodatkowych ścieżek.
Przegląd drugiej osoby i jawność ról
Dla ustaleń o dużym znaczeniu proponujemy kontrolę przez drugą kompetentną osobę: ocenę dowodów, uzasadnienia priorytetu i kryterium retestu. Ta osoba zapisuje, które elementy sprawdziła samodzielnie; powtarzanie każdej próby nie jest konieczne. Brak drugiego przeglądu w małym projekcie nie odbiera raportowi automatycznie wartości. Trzeba go jednak ujawnić przy ustalaniu oczekiwanego poziomu zapewnienia.
Ten sam wykonawca może diagnozować i naprawiać, jeżeli role i sposób odbioru zostaną rozdzielone. Przy istotnej zmianie pomaga niezależny przegląd retestu. Wtedy „zamknięcie zadania” nie opiera się wyłącznie na deklaracji jego autora. Konflikt interesów jest informacją, którą należy zarządzać. Sam w sobie nie jest powodem do zarzucania wykonawcy nierzetelności.
Umów moment zakończenia zlecenia i oddziel go od końca ryzyka
Zlecenie może kończyć się przekazaniem raportu, wykonaniem uzgodnionego retestu lub potwierdzeniem określonych kryteriów. Każdy wariant jest dopuszczalny, jeżeli jasno go opisano. Odbiór pracy nie oznacza jednak akceptacji wszystkich pozostałych zagrożeń. Sprawy nierozstrzygnięte wymagają osobnej decyzji: dalszego badania, naprawy, ograniczenia funkcji albo świadomego przyjęcia ryzyka przez uprawnioną osobę.
Publiczny komunikat podaje datę, zakres i charakter badania bez szczegółów ułatwiających nadużycia. Sformułowanie „wykonano audyt i wdrożono wskazane poprawki” wymaga potwierdzenia obu działań. Hasła „100% bezpieczeństwa”, „pełna zgodność z prawem” czy „certyfikat OWASP” nie mogą zastępować rzetelnego opisu usługi. Samo użycie wybranych wymagań ASVS nie oznacza pełnej weryfikacji poziomu standardu.[1]
Profesjonalny audyt daje więc dwa wyniki: raport o systemie oraz możliwość sprawdzenia jakości samego badania. Odbiorca widzi, na jakiej podstawie sformułowano wnioski, gdzie leży ich granica i co musi się wydarzyć, aby wymagały ponownej oceny.
Rozdział 31Bezpieczeństwo zaczyna się od sprawdzenia, a kończy na potwierdzonej zmianie
Profesjonalny audyt prowadzi od rozpoznanego zasobu i uzasadnionego scenariusza do sprawdzonej kontroli, dowodu, decyzji i zweryfikowanej naprawy. Dobry raport porządkuje odpowiedzialność, ogranicza ostrzeżenia do uzasadnionych i nie obiecuje pełnej odporności.
W WordPressie oznacza to kontrolę nad rozszerzeniami, dostępami i utrzymaniem. W WooCommerce dochodzi sprawdzenie procesu sprzedażowego, danych klientów i odtwarzania. Zakres musi odpowiadać temu, co ma znaczenie dla konkretnej organizacji.
Sprawdź zabezpieczenia swojej strony, zanim decyzje wymusi incydent. Ustal zakres badania, poznaj potwierdzone ryzyka i zaplanuj naprawy wraz z retestem. Rezultatem powinny być weryfikowalne ustalenia i jasno określone granice potwierdzenia, bez obietnic „100% bezpieczeństwa”.
Dodatek AKarta odbioru audytu i skuteczności napraw
Poniższe kryteria proponujemy zaadaptować w zleceniu. Wymagają dopasowania i nie mają mocy umowy ani standardu prawnego. Pomagają ocenić pracę na podstawie weryfikowalnego wyniku. Przy każdym kryterium wskazuje się status, właściciela decyzji i odnośnik do dowodu.
| ID | Kryterium odbioru | Minimalny rezultat do okazania |
|---|---|---|
| ODB-01 | Zakres i ograniczenia są jednoznaczne. | Domeny, środowiska, funkcje, role, integracje i wyłączenia. |
| ODB-02 | Testy były upoważnione i kontrolowane. | Zasady prowadzenia prac, kontakt awaryjny i warunki przerwania. |
| ODB-03 | Scenariusze mają widoczny status. | Rejestr prób wraz z pozycjami „nie zweryfikowano” i uzasadnieniami. |
| ODB-04 | Istotne ustalenia mają dowody. | Materiał potwierdzający obserwację, warunki i zakres wpływu. |
| ODB-05 | Uprawnienia sprawdzono na poziomie zasobów. | Próby poprawnego dostępu i odmowy dla różnych kont lub organizacji. |
| ODB-06 | Aktualizacje obejmują rzeczywiste zależności. | Wersje, źródła kodu, wsparcie, właściciele i decyzje o podatnościach. |
| ODB-07 | Kopie oceniono w uzgodnionym zakresie. | Protokół odtworzenia albo jawne zastrzeżenie, że go nie wykonano. |
| ODB-08 | Sprawdzono działanie alarmowania, jeśli było w zakresie. | Oś czasu testowego zdarzenia, dostarczenia i reakcji. |
| ODB-09 | Ryzyko ma uzasadnienie i właściciela. | Rozdzielenie dotkliwości, pewności ustalenia, pilności i decyzji. |
| ODB-10 | Plan napraw jest wykonalny. | Odpowiedzialność, zależności, terminy i kryteria sprawdzenia. |
| ODB-11 | Retest dotyczy wdrożonej zmiany. | Środowisko, wersja, powtórzony scenariusz i kontrola potrzebnych funkcji. |
| ODB-12 | Zakończono dostęp i uporządkowano materiały. | Odwołane konta testowe, zasady retencji oraz lista otwartych ryzyk. |
Przykładowy zapis zamknięcia ustalenia
Wzór: „Ustalenie AUD-01 zweryfikowano ponownie na wskazanej wersji i we wskazanym środowisku. Konto testowe A nie uzyskało dokumentu konta B w ścieżkach objętych próbą, a właściciel dokumentu zachował dostęp. Dowody powiązano z zadaniem naprawczym. Nie oceniano kanałów wskazanych w wyłączeniach. Status: naprawiono w zbadanym zakresie”.
Taki zapis jest bardziej użyteczny niż „naprawa wykonana”, ponieważ opisuje wynik i granice potwierdzenia. Jeżeli zastosowano wyłącznie regułę ochronną, status wskazuje ograniczenie ryzyka. Jeżeli testu nie dało się wykonać, zapisuje się przyczynę i warunek ponownej weryfikacji. Problem pozostaje wtedy otwarty, bo sama deklaracja nie wystarcza do jego zamknięcia.
Dodatek BOdpowiedzialność i wyjątki od zabezpieczeń
Macierz odpowiedzialności do uzgodnienia
Poniższy model nie narzuca struktury organizacyjnej. W małej firmie jedna osoba może pełnić kilka ról. Nadal warto jednak odróżniać wykonanie zadania od zatwierdzenia ryzyka i sprawdzenia rezultatu. Przy istotnych ustaleniach wynik naprawy powinien w miarę możliwości ocenić ktoś inny niż jej autor.
| Decyzja lub zadanie | Odpowiedzialny za wykonanie | Zatwierdzający lub odbiorca |
|---|---|---|
| Zakres i upoważnienie do audytu | Koordynator po stronie właściciela. | Osoba uprawniona do dysponowania zasobami. |
| Naprawa kodu WordPressa lub sklepu | Właściciel aplikacji / wykonawca zmian. | Właściciel usługi; wynik weryfikuje audytor lub wyznaczony tester. |
| Ograniczenie ekspozycji na poziomie hostingu | Administrator infrastruktury lub dostawca. | Osoba uprawniona do decyzji o dostępności usługi. |
| Ocena obowiązku zgłoszenia naruszenia danych | Administrator danych przy wsparciu właściwych specjalistów. | Osoba umocowana po stronie administratora. |
| Akceptacja ryzyka i wyjątku | Właściciel ryzyka biznesowego. | Osoba z odpowiednim mandatem, zgodnie z zasadami organizacji. |
| Przywrócenie sprzedaży po odtwarzaniu | Zespół techniczny i właściciel procesu sprzedaży. | Właściciel usługi po weryfikacji kryteriów uruchomienia. |
Tabela przedstawia proponowany podział pracy. Odpowiedzialność ustawowa pozostaje przy podmiotach, na których ciąży, i nie przechodzi przez ten podział na audytora ani dostawcę.
Karta wyjątku z terminem i warunkiem wyjścia
Przykładowa karta zawiera identyfikator ustalenia, powód odstępstwa, zasób, potwierdzony wpływ, zabezpieczenie zastępcze, właściciela decyzji, termin przeglądu i zdarzenie kończące wyjątek. Osobno zapisuje się, kto monitoruje skuteczność środka zastępczego. Wyjątek bez terminu i warunku wyjścia zamienia się w bezterminową akceptację. Samo oczekiwanie na dostawcę nie jest dowodem ograniczenia ekspozycji.
Przykład fikcyjny: funkcja eksportu zostaje czasowo wyłączona do wydania poprawki. Ograniczenie potwierdzono w kanałach objętych zakresem. Przywrócenie funkcji wymaga testu SCN-01, a pojawienie się nowego kanału eksportu uruchamia ponowną ocenę niezależnie od terminu przeglądu. Status ustalenia brzmi „ograniczono ryzyko”, ponieważ przyczyna nie została jeszcze usunięta.
Dodatek CRejestr dowodów i słownik pojęć
Minimalny zapis pojedynczego dowodu
Proponowany identyfikator, na przykład EVD-SCN01-03, łączy materiał ze scenariuszem i konkretną próbą. Zapis obejmuje cel, wersję i środowisko, czas ze strefą, rolę testową, oczekiwany i zaobserwowany wynik oraz lokalizację materiału. Dochodzą do tego autor, redakcja danych, ograniczenia oraz termin lub zdarzenie ponownej weryfikacji. Sama nazwa pliku bez tych informacji nie zapewnia powtarzalności.
| Bramka odbioru materiału | Pytanie kontrolne |
|---|---|
| Adekwatność | Czy materiał potwierdza sam wniosek, czy wyłącznie stan ustawienia? |
| Powtarzalność | Czy inna uprawniona osoba rozumie warunki i może powtórzyć próbę? |
| Minimalizacja | Czy usunięto niepotrzebne dane osobowe i kompletne poświadczenia? |
| Aktualność | Czy dowód dotyczy wskazanej wersji i nadal adekwatnej konfiguracji? |
| Rozliczalność | Czy ustalenie prowadzi do właściciela decyzji, naprawy i wyniku retestu? |
| Ograniczenia | Czy jasno wskazano kanały, funkcje lub okresy pozostające poza badaniem? |
Rejestru nie trzeba publikować w całości w artykule ofertowym ani udostępniać wszystkim pracownikom. Wersja zarządcza może zawierać identyfikator i podsumowanie, a materiał techniczny pozostaje w kontrolowanym repozytorium. Audyt ma zmniejszać ryzyko wycieku, więc nie powinien tworzyć nowego, niechronionego archiwum informacji o stronie.
Słownik pojęć użytych w części praktycznej
Kontrola bezpieczeństwa to zabezpieczenie lub działanie oceniane względem ustalonego celu. Dowód to materiał uzasadniający konkretny wniosek. Pokrycie opisuje, jaką część uzgodnionego zakresu rzeczywiście zbadano. Próba pozytywna potwierdza poprawność dozwolonej operacji, a próba negatywna skuteczność odmowy. Test regresyjny ma wykryć powrót błędu po zmianie.
Idempotencja oznacza w omawianym scenariuszu, że ponowne przetworzenie tego samego zdarzenia nie wywołuje dodatkowego, niezamierzonego skutku biznesowego. Ryzyko rezydualne to ryzyko, które pozostaje po zastosowaniu zabezpieczeń. Bramka wdrożeniowa to uzgodniony warunek dopuszczenia zmiany; określenie nie odnosi się do konkretnego narzędzia. Dryf konfiguracji to odejście bieżących ustawień od przyjętego i ocenionego stanu odniesienia.
Dodatek DKarta łańcucha ryzyka i uzasadnienia kontroli
Poniższy wzór służy do pracy nad konkretnym scenariuszem. Nie zawiera wyników testu i nie powinien trafiać do klienta jako wypełniony rejestr ryzyka. Wszystkie pola odnosi się do rzeczywistego środowiska, zakresu upoważnienia i dowodów.
Identyfikacja: nazwa usługi, właściciel procesu, identyfikator scenariusza, data, wersja systemu i osoba opracowująca. Szkoda: jakie zdarzenie biznesowe chcemy ograniczyć i kogo ono dotyczy? Początek ścieżki: jakie uprawnienie, dostęp lub zdarzenie stanowi warunek wejściowy?
Dla każdego kolejnego etapu zapisz warunek konieczny, przekraczaną granicę zaufania oraz status: potwierdzony, wynikający z konfiguracji albo hipotetyczny. Dołącz identyfikator dowodu i ograniczenie. Etapu, którego nie wolno sprawdzić, nie oznaczaj jako zakończonego pomyślnie. Podaj właściciela potrzebnej decyzji lub dostępu.
Kontrola zapobiegająca: które przejście ma uniemożliwić i jak sprawdzimy efekt? Kontrola wykrywająca: jakie zdarzenie ma wywołać alarm i kto potwierdzi jego obsługę? Odtwarzanie: co można odzyskać, czego odzyskanie nie naprawi i jakie zależności mogą utrudnić reakcję?
W części decyzyjnej zapisz wspólne zależności zabezpieczeń, ryzyko pozostałe, wybrany sposób postępowania, właściciela, termin oraz zdarzenia wymagające ponownej oceny. Sam wpis „zaakceptowano” jest niewystarczający: trzeba wskazać, co dokładnie zaakceptowano i na jakiej podstawie.
Warunek zamknięcia karty: udokumentowano stan każdego istotnego przejścia, wynik sprawdzenia wybranej bariery i decyzję wobec granic niezweryfikowanych. Zamknięcie karty dokumentacyjnej nie oznacza automatycznego usunięcia całego ryzyka.
Dodatek EProtokół niezależnego przeglądu jakości audytu
Ten wzór uzupełnia kartę odbioru z dodatku A. Służy do sprawdzenia jakości zakresu i wniosków; uniwersalna ocena w rodzaju „bezpieczeństwo: 95%” wykracza poza jego cel. Przegląd może być proporcjonalny do skali projektu, a jego rzeczywisty zakres musi pozostać jawny.
| Etap przeglądu | Zapis wymagany we wzorze | Warunek zakończenia |
|---|---|---|
| Zakres i upoważnienie | Zasoby, role, funkcje, środowiska, ograniczenia i zatwierdzone zmiany. | Każdy element zakresu ma wynik albo jawną przyczynę niewykonania. |
| Wnioski istotne biznesowo | Wybrane ustalenia, dowody, założenia i sposób doboru próby. | Wniosek mieści się w granicach dowodu; zbadano sensowną alternatywną interpretację. |
| Priorytety i naprawy | Uzasadnienie pilności, właściciel, plan oraz skutki uboczne. | Oddzielono naprawę przyczyny, ograniczenie ekspozycji i akceptację ryzyka. |
| Retest | Wersja wdrożenia, scenariusze, wyniki i nierozstrzygnięte granice. | Status zamknięcia odpowiada faktycznemu zakresowi ponownego badania. |
| Komunikacja i materiały | Odbiorcy raportu, redakcja danych, retencja dowodów i treść komunikatu publicznego. | Nie ujawniono sekretów ani nie przypisano usłudze szerszego zapewnienia. |
Zapis końcowy: osoba przeglądająca, relacja do wykonawcy, data, przejrzane elementy, elementy odtworzone samodzielnie, rozbieżności i uzgodnione działania. Oznaczenie „przegląd niezależny” wymaga wyjaśnienia, na czym polega niezależność. Sam podpis drugiej osoby z tego samego procesu jej nie dowodzi.
Przy spornym ustaleniu zachowuje się obie interpretacje i wskazuje próbę, która może je rozstrzygnąć. Obserwacji nie usuwa się wyłącznie dlatego, że utrudnia odbiór projektu. Zarzutu nie podtrzymuje się też wtedy, gdy późniejszy wiarygodny dowód wykazał błędną interpretację. Historia korekty jest częścią jakości raportu.
Protokół i karty z dodatków D i E to wzory do wypełnienia. Pola pozostawione bez wyniku nie są oceną konkretnej strony, a wypełniony wzór nie jest oficjalnym formatem OWASP ani NIST i nie stanowi certyfikatu.
Zespół icomSEOAutorzy artykułu
Autorem przewodnika jest Arkadiusz Urbaś, który w icomSEO prowadzi audyty bezpieczeństwa i audyty zgodności prawnej stron. Przy opracowaniu współpracowali Dawid Sasiela i Piotr Antoszek. Karty prowadzą do profili autorów.
 AutorArkadiusz UrbaśChief Technology OfficerProfil autora →
 WspółautorDawid SasielaChief Sales OfficerProfil autora →
 WspółautorPiotr AntoszekPrezes spółkiProfil autora →
Czytaj dalejPowiązane materiały
Materiały źródłoweŹródła
Data dostępu: 14 października 2026 r. Standardy, dokumentacja dostawców, akty prawne i raporty mają różny charakter. Przed wykorzystaniem w konkretnej sprawie warto sprawdzić aktualność przepisów i dokumentacji. Proponowane scenariusze, karty i modele kosztów są opracowaniem icomSEO.
- OWASP, ASVS 5.0.0: wymagania weryfikacji bezpieczeństwa aplikacji
- OWASP, WSTG 4.2: metodyka testowania aplikacji WWW
- Patchstack, State of WordPress Security in 2025; dane za 2024 r.
- Patchstack, State of WordPress Security in 2026; dane za 2025 r.
- NASK, Raport roczny z działalności CERT Polska w 2025 roku
- OWASP, Threat Modeling Cheat Sheet
- WordPress, Hardening WordPress
- OWASP, Transport Layer Security Cheat Sheet
- OWASP, Vulnerable Dependency Management Cheat Sheet
- OWASP, Authentication Cheat Sheet
- OWASP, Multifactor Authentication Cheat Sheet
- OWASP, Authorization Cheat Sheet
- OWASP, Session Management Cheat Sheet
- OWASP, SQL Injection Prevention Cheat Sheet
- OWASP, Cross Site Scripting Prevention Cheat Sheet
- OWASP, Server Side Request Forgery Prevention Cheat Sheet
- OWASP, File Upload Cheat Sheet
- OWASP, HTTP Headers Cheat Sheet
- OWASP, REST Security Cheat Sheet
- OWASP, Third Party JavaScript Management Cheat Sheet
- OWASP, Secrets Management Cheat Sheet
- OWASP, CI/CD Security Cheat Sheet
- OWASP, Logging Cheat Sheet
- WordPress, Nonces
- WordPress, Checking User Capabilities
- WordPress, Adding Custom Endpoints: REST API
- WordPress, Must-Use Plugins
- WordPress, Editing wp-config.php
- WordPress, wp core verify-checksums
- WordPress, wp plugin verify-checksums
- WordPress, Application Passwords: REST API
- WordPress, Escaping Data
- WordPress, Validating Data
- OWASP WSTG, Business Logic Testing
- OWASP, Transaction Authorization Cheat Sheet
- OWASP, Third Party Payment Gateway Integration Cheat Sheet
- WooCommerce, Webhooks
- WooCommerce, Advanced Settings
- CISA, #StopRansomware Guide: kopie zapasowe i odtwarzanie
- NIST CSRC, Recovery Point Objective: definicja RPO
- NIST CSRC, Recovery Time Objective: definicja RTO
- RODO, rozporządzenie (UE) 2016/679; art. 5, 25, 28, 32–34
- UODO, termin zgłoszenia naruszenia i obowiązki administratora
- UODO, komunikat o obowiązkach z art. 33 i 34 RODO
- Prawo komunikacji elektronicznej, Dz.U. 2024 poz. 1221; art. 399–400
- Nowelizacja ustawy o KSC, ustawa z 23 stycznia 2026 r., Dz.U. 2026 poz. 252
- Ministerstwo Cyfryzacji, nowelizacja ustawy o KSC
- Ministerstwo Cyfryzacji, wejście w życie KSC i harmonogram obowiązków
- Ministerstwo Cyfryzacji, samorejestracja KSC: warunki terminu 3 października 2026 r.
- Komisja Europejska, Cyber Resilience Act: zakres i terminy
- Komisja Europejska, CRA a oprogramowanie open source
- Google Search Console, Raport Problemy dotyczące bezpieczeństwa
- Google Search Central, Understanding Google Page Experience
- FIRST, CVSS v4.0 User Guide
- FIRST, Exploit Prediction Scoring System (EPSS)
- CISA, komunikat o KEV i priorytetyzacji potwierdzonych nadużyć
- OWASP WSTG, Reporting
- OWASP, Cross-Site Request Forgery Prevention Cheat Sheet
- OWASP, PHP Configuration Cheat Sheet
- OWASP, Web Cache Security Cheat Sheet
- OWASP, Forgot Password Cheat Sheet
- WordPress, Cron: wykonywanie zadań zaplanowanych
- Komisja Europejska, CRA: obowiązki zgłaszania i odrębność open-source stewards
- PCI SSC, FAQ 1588: SAQ A i bezpieczeństwo skryptów płatności
- NIST SP 800-61 Rev. 3, reagowanie na incydenty w zarządzaniu ryzykiem
- NIST, Cybersecurity Framework 2.0
- IETF, RFC 9116: security.txt i zgłaszanie podatności
- WooCommerce, Store API: zakres i ograniczenia
- WooCommerce, High-Performance Order Storage (HPOS)
- WordPress, Application Passwords: administracja i odwoływanie dostępów
- EDPB, Data breaches: obowiązki administratora i podmiotu przetwarzającego
- Ministerstwo Cyfryzacji, KSC: obowiązki podmiotów kluczowych i ważnych
- OWASP, Virtual Patching Cheat Sheet
- Google Search Central, blokowanie indeksowania za pomocą noindex
- OWASP ASVS 5.0.0, V8 Authorization; wydanie oznaczone v5.0.0
- OWASP ASVS 5.0.0, V7 Session Management; wydanie oznaczone v5.0.0
- OWASP ASVS 5.0.0, V5 File Handling; wydanie oznaczone v5.0.0
- OWASP ASVS 5.0.0, V16 Security Logging and Error Handling
- CERT Polska, raport roczny za 2025 r.; publikacja zespołu
- NIST SP 800-53A Rev. 5, metody oceny zabezpieczeń
- OWASP, Authorization Testing Automation Cheat Sheet
- NIST SP 800-218, Secure Software Development Framework 1.1
- NIST SP 800-161 Rev. 1, Update 1, ryzyko łańcucha dostaw
- NIST SP 800-137, Information Security Continuous Monitoring
- OWASP, Content Security Policy Cheat Sheet
- WooCommerce, Rate Limiting for Store API endpoints
- WordPress WP-CLI, wp plugin list
- WordPress WP-CLI, wp theme list
- NIST SP 800-63B-4, Authentication and Authenticator Management; wydanie finalne 2025
- NIST SP 800-63B-4, wymagania uwierzytelniania i odporność na phishing
- NIST SP 800-63B-4, zarządzanie metodami i odzyskiwanie konta
- WordPress REST API, Posts: kontekst odpowiedzi i statusy treści
- WordPress, WP_Object_Cache i trwała pamięć obiektowa
- WooCommerce, Accounts and Privacy Settings: retencja i usuwanie danych
- NIST IR 8286D, Update 1, Business Impact Analysis; wydanie z lutego 2025
- NIST SP 800-30 Rev. 1, Guide for Conducting Risk Assessments
- SLSA v1.1, Provenance: pochodzenie artefaktu i dane o budowaniu
- OWASP CycloneDX, Software Bill of Materials: zakres zestawienia składników
- WordPress, Adding the Personal Data Eraser to Your Plugin
- Unia Europejska, Your Europe, prawa dotyczące danych i wyjątki od usunięcia